running_the_code/02_modal_endpoints.mdXem bản gốc Bản dịch đầy đủ theo đúng cấu trúc tài liệu; code, liên kết và định danh kỹ thuật được giữ nguyên.
Danh mục mô hình phương thức - Chọn và phục vụ mô hình cho decode Khai thác
Ảnh chụp nhanh: 26-06-2026, đọc từ luồng Điểm cuối tự động "Tạo điểm cuối" của Modal. Điểm chuẩn các số liệu là ước tính của Modal — coi chúng là tương đối và xác thực bằng
modal endpoint benchmark. Danh mục trôi dạt; kiểm tra lại bảng điều khiển trước khi cam kết ngân sách GPU.
TL;DR
Đối với khai thác coding agent ReAct (vòng lặp công cụ LLM ⇄, phân phối tương thích với OpenAI), hãy xử lý thông qua điều này khóa học:
| Chọn | ID mẫu | GPU agent | Tại sao |
|---|---|---|---|
| ** Phù hợp nhất — mặc định của khóa học ** | Qwen/Qwen3.6-35B-A3B-FP8 | 1×H100 | Giao bóng rẻ nhất với biên độ rộng (MoE, ~3B hoạt động); gọi công cụ Qwen mạnh mẽ thông qua hermes/qwen trình phân tích cú pháp. Bạn sẽ chạy lại vòng lặp hàng trăm lần trong khi xây dựng - đây là vòng lặp cho phép bạn làm điều đó mà không cần phân bổ tín dụng |
| Trung bình | openai/gpt-oss-120b | 1×B200 | Định dạng lệnh gọi công cụ OpenAI gốc → ít gây cản trở nhất; ~2–3× khả năng tương tác. Bước lên đây khi quá trình quay vòng chậm bắt đầu khiến bạn tốn nhiều thời gian hơn GPU |
| Khả năng tối đa | zai-org/GLM-5.2-FP8 | 8×B200 | Điều chỉnh mã hóa agent hàng đầu - mức trần của những gì harness có thể làm. 8× GPU ở mức đắt nhất; dự trữ cho những nhiệm vụ khó khăn (zai-org/GLM-4.7 là dự phòng rẻ hơn) |
Cả ba đều là thang chi phí/năng lực, không phải xếp hạng — mỗi bước của khóa học này đều được xây dựng và đã được thử nghiệm dựa trên mặc định của Qwen. Hãy vươn lên bậc thang khi một nhiệm vụ cụ thể thực sự yêu cầu điều đó.
Phần còn lại của danh mục (23 mẫu: 12 Qwen, 4 Gemma, GPT-OSS, Nemotron, 2 DeepSeek, 2 GLM,
Kimi) có thể duyệt được trong bảng điều khiển. Bỏ qua các mẫu nhỏ (Qwen ≤9B, Gemma E2B/E4B — không cầm được
kỷ luật công cụ) và những người khổng lồ biên giới (Qwen3.5-397B-A17B-FP8, DeepSeek-V4-Pro,
nvidia/Kimi-K2.6-NVFP4 - quá tốn kém cho một repository giảng dạy).
Tiêu chí lựa chọn cho khai thác coding agent
Được xếp hạng theo mức độ quan trọng của mỗi thứ decodevòng lặp của trong khi bạn đang học nó:
- Độ tin cậy của lệnh gọi công cụ / hàm — #1. Một mô hình định dạng sai các lệnh gọi công cụ sẽ tạo ra vòng lặp
không thể dạy được: cuối cùng bạn sẽ gỡ lỗi mô hình thay vì harness của mình. Định dạng OpenAI gốc
(GPT-OSS) mượt nhất nhưng của Qwen
hermes/qwentrình phân tích cú pháp cũng xóa thanh này - và xóa thanh là những gì được tính ở đây, không giành được nó. - Chi phí cho mỗi lần lặp lại quá trình học tập. Dành riêng cho khóa học và lý do mặc định là: bạn sẽ chạy vòng lặp hàng trăm lần, hầu hết lần lượt bạn đã hiểu. Một model ~một thứ tự rẻ hơn nhiều để phục vụ cho số lần mua tương ứng với nhiều lần thử hơn từ một khoản tín dụng cố định ngân sách. Trên production harness, tiêu chí này sẽ xếp cuối cùng; ở đây nó đứng thứ hai.
- Ngữ cảnh dài ( ≥128k) — toàn bộ tệp, phát lại phiên, nén; điểm chuẩn agent bên dưới sử dụng đầu vào token 61k, phản ánh kết quả công cụ tích lũy.
- Khả năng mã hóa — quan trọng, nhưng một lập trình viên giỏi mà không thể điều khiển các công cụ thì sẽ vô dụng ở đây, và Phần khó của khóa học này là harness chứ không phải trần mã hóa thô của mô hình.
- Hướng dẫn sau — chế độ cấp phép, định nghĩa agent, kết quả đầu ra có cấu trúc.
- Dấu chân có thể phân phối — thông số hoạt động + lượng tử hóa → số lượng GPU → độ trễ & chi phí; mô hình MoE là điểm thú vị, đó chính xác là lý do tại sao mẫu 35B-A3B lại phục vụ trên một chiếc H100.
Trình phân tích cú pháp cứng: mô hình phải phân phối thông qua vLLM bằng trình phân tích cú pháp cuộc gọi công cụ đang hoạt động (OpenAI/harmony cho GPT-OSS, hermes/qwen cho Qwen). Xác nhận trong Cấu hình nâng cao.
Đối đầu được điểm chuẩn (bản xem trước ước tính của Modal)
Khối lượng công việc "Agentic multi-turn" — đầu vào 61.278 token, đầu ra 1.521 token:
| ID mẫu | GPU | Mức độ tương tác cao nhất (tok/s/user) | Chi phí phân phát tương đối |
|---|---|---|---|
Qwen/Qwen3.6-35B-A3B-FP8 (mặc định khóa học) | 1×H100 | ~86 | thấp nhất |
openai/gpt-oss-120b | 1×B200 | ~234 → 90 | trung bình |
zai-org/GLM-5.2-FP8 | 8×B200 | ~112–168 | cao nhất (~8× GPU ở mức đắt nhất) |
Cách đọc phần này: Qwen là ứng dụng có tốc độ chậm nhất trên mỗi người dùng và rẻ nhất tính theo biên độ rộng — đối với một vòng lặp, bạn vẫn đang xây dựng, chờ thêm vài giây mỗi lượt là nguồn tài nguyên rẻ và số giờ sử dụng GPU là khan hiếm một. GPT-OSS mua ~2–3× khả năng tương tác để tăng mức thực sự mỗi giờ; hãy lấy nó một khi bạn chạy khai thác hơn là viết nó. GLM là tùy chọn cao cấp — thực sự là tùy chọn có khả năng nhất trong số ba người thực hiện các nhiệm vụ agent khó và được định giá tương ứng.
Đọc các con số tương tác dưới dạng tương đối, không phải như một lời hứa: chúng là ước tính của chính Modal, và một chiếc B200 so với một chiếc H100 là sự khác biệt về phần cứng giống như một mẫu máy.
Thiết lập điểm cuối thông qua Modal CLI (Điểm cuối tự động)
Tài liệu: hướng dẫn về điểm cuối ·
số liệu ·
điểm chuẩn. Nếu một lá cờ bị trôi đi, modal điểm cuối tạo --help là nguồn gốc của sự thật.
Xác thực CLI
modal token set --token-id <your-token-id> --token-secret <your-token-secret>
# or set MODAL_TOKEN_ID / MODAL_TOKEN_SECRET (see .env.example)
Các token tài khoản này xác thực CLI và Hộp cát phương thức (SANDBOX_MODE=modal) —
khác biệt với các token điểm cuối/proxy bên dưới, đó là cách decode gọi mô hình được phục vụ của bạn.
Tạo điểm cuối
modal endpoint create --model Qwen/Qwen3.6-35B-A3B-FP8 --env main    # best fit
modal endpoint create --model openai/gpt-oss-120b --env main         # middle ground
modal endpoint create --model zai-org/GLM-5.2-FP8 --env main         # max capability (8×B200)
Modal tự động chọn công thức phục vụ + cấu hình GPU và in ID điểm cuối, URL và liên kết trang tổng quan.
Xác thực - token proxy
Điểm cuối yêu cầu xác thực theo mặc định. Tạo một cặp token (và đưa nó vào phạm vi env nếu RBAC được bật):
modal workspace proxy-tokens create        # → Modal-Key: wk-... / Modal-Secret: ws-...
modal workspace proxy-tokens allow wk-... main
Chỉ dành cho phát triển cục bộ, bỏ qua xác thực tại thời điểm tạo với --unauthenticated.
Xác minh - điểm cuối nói Hoàn thành trò chuyện OpenAI tại /v1
curl "<your-endpoint-url>/v1/models" \
  -H "Modal-Key: $MODAL_PROXY_TOKEN_ID" \
  -H "Modal-Secret: $MODAL_PROXY_TOKEN_SECRET"
Cấu hình nâng cao - CLI so với bảng điều khiển
| Núm | CLI tại tạo | Bảng điều khiển sau khi tạo |
|---|---|---|
| Vùng định tuyến | --routing-region (mặc định chúng tôi-tây, chúng tôi-đông, eu-tây, ap-nam) | Chi tiết → Vùng định tuyến |
| Tính toán vị trí | --colocate-compute (ghim vùng chứa vào vùng định tuyến) | Chi tiết → Tính toán Vị trí |
| Vùng chứa tối thiểu / tối đa / đệm | - (không được hỗ trợ) | TỰ ĐỘNG SCALING → Chỉnh sửa → Ghi đè |
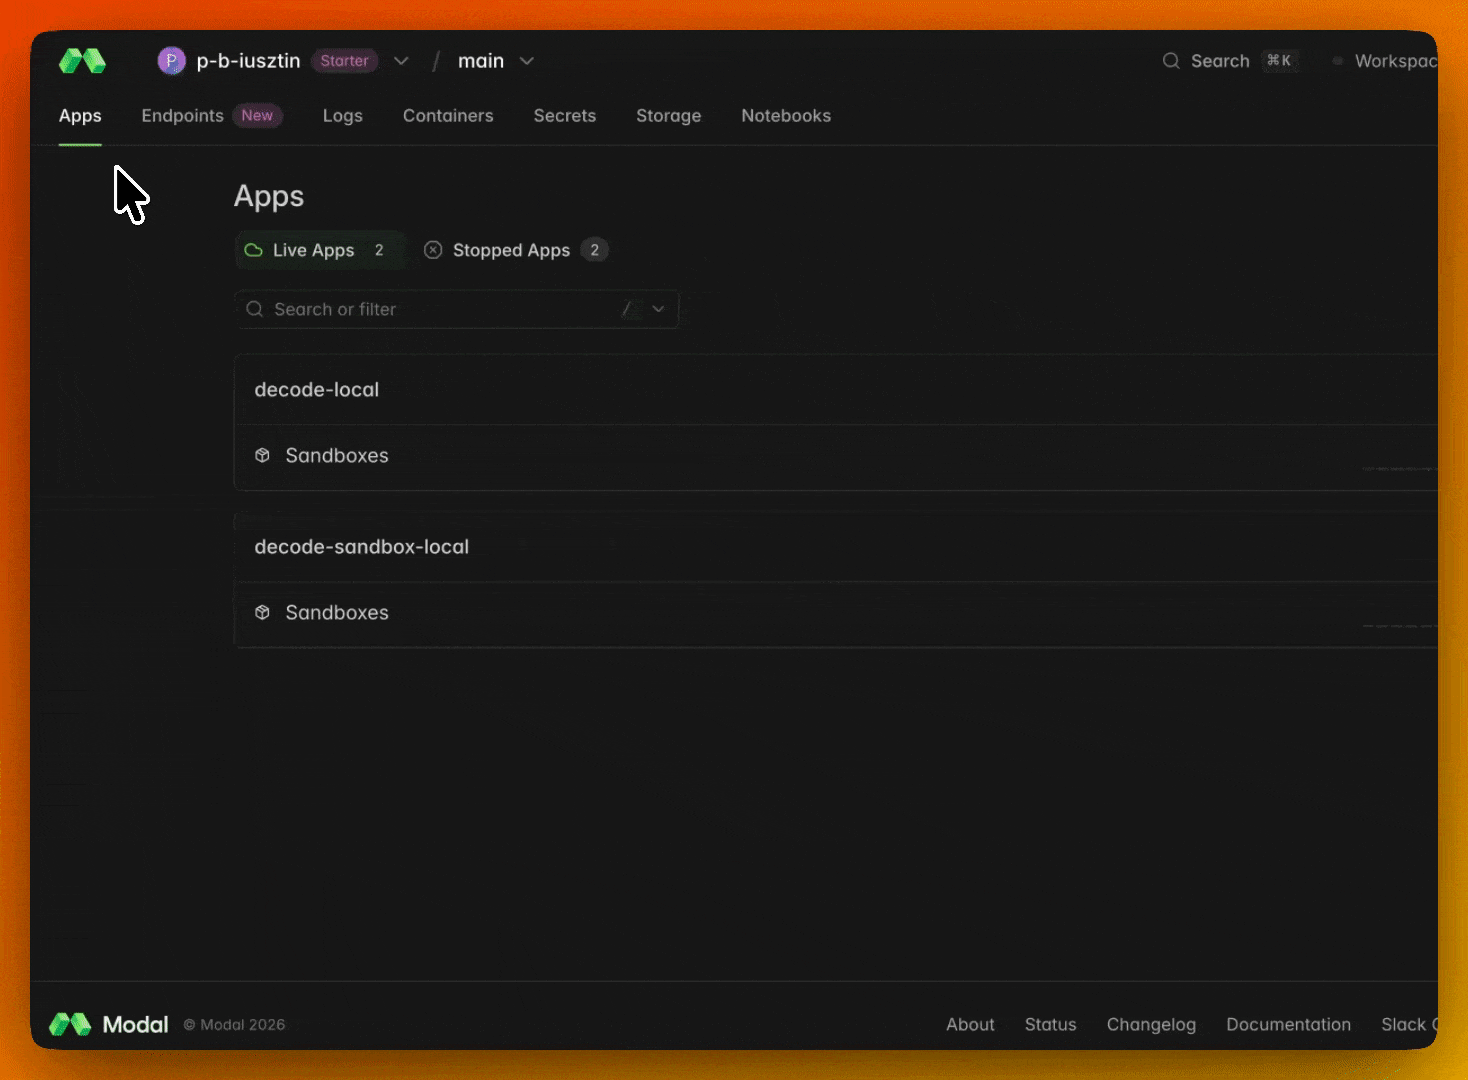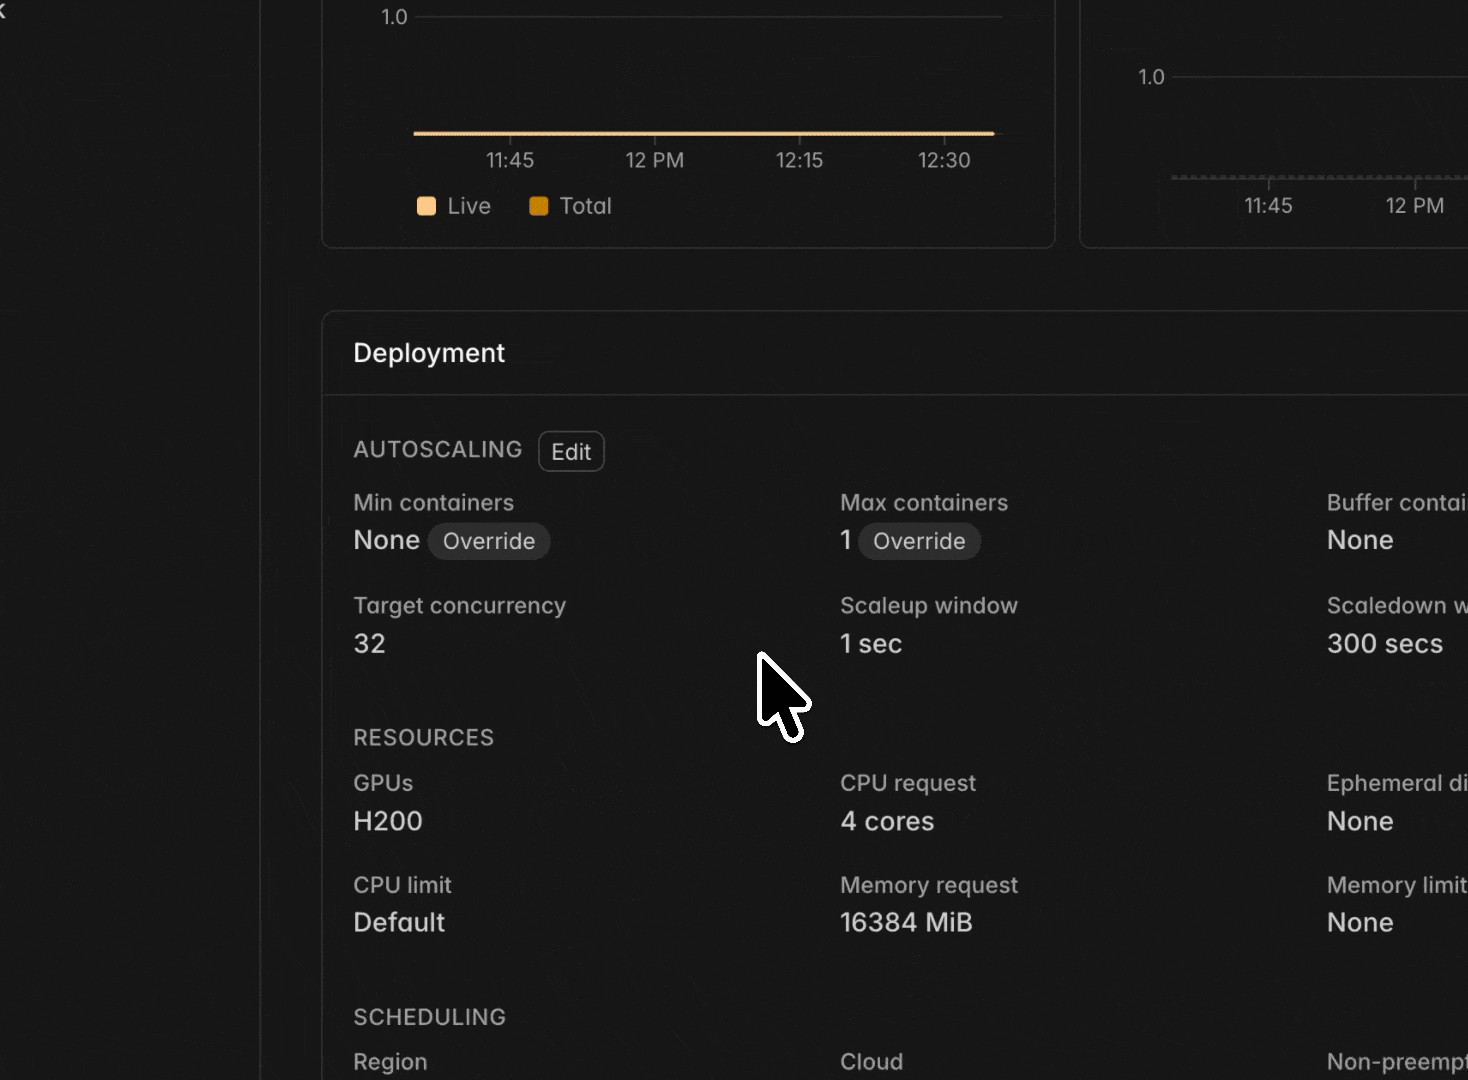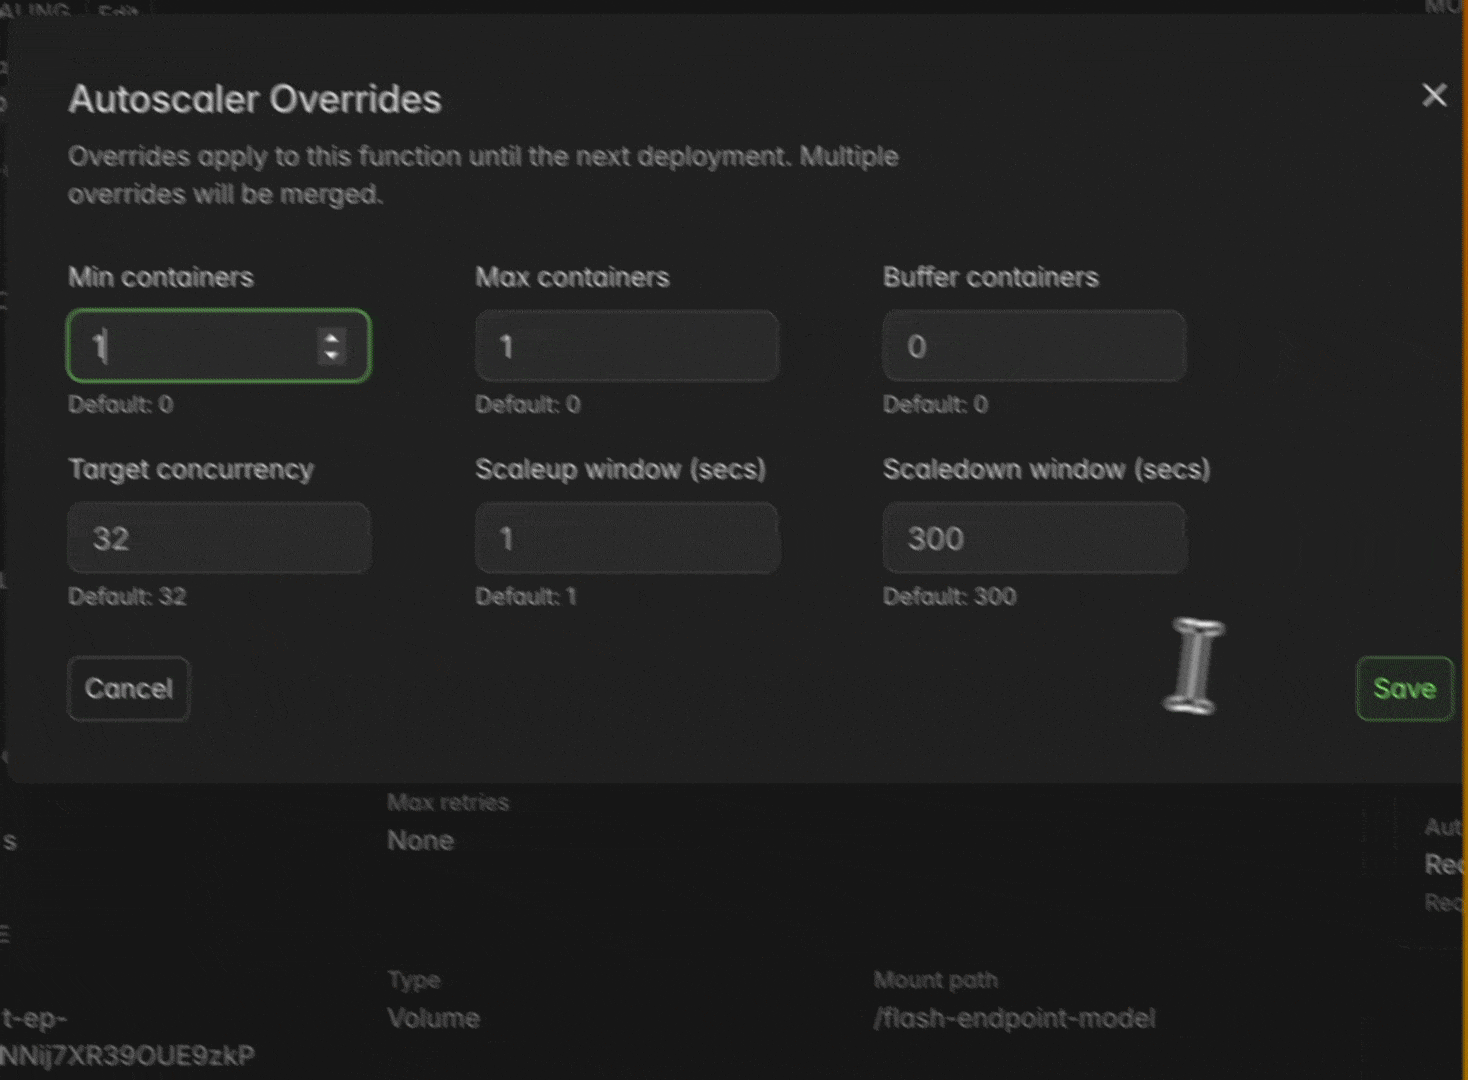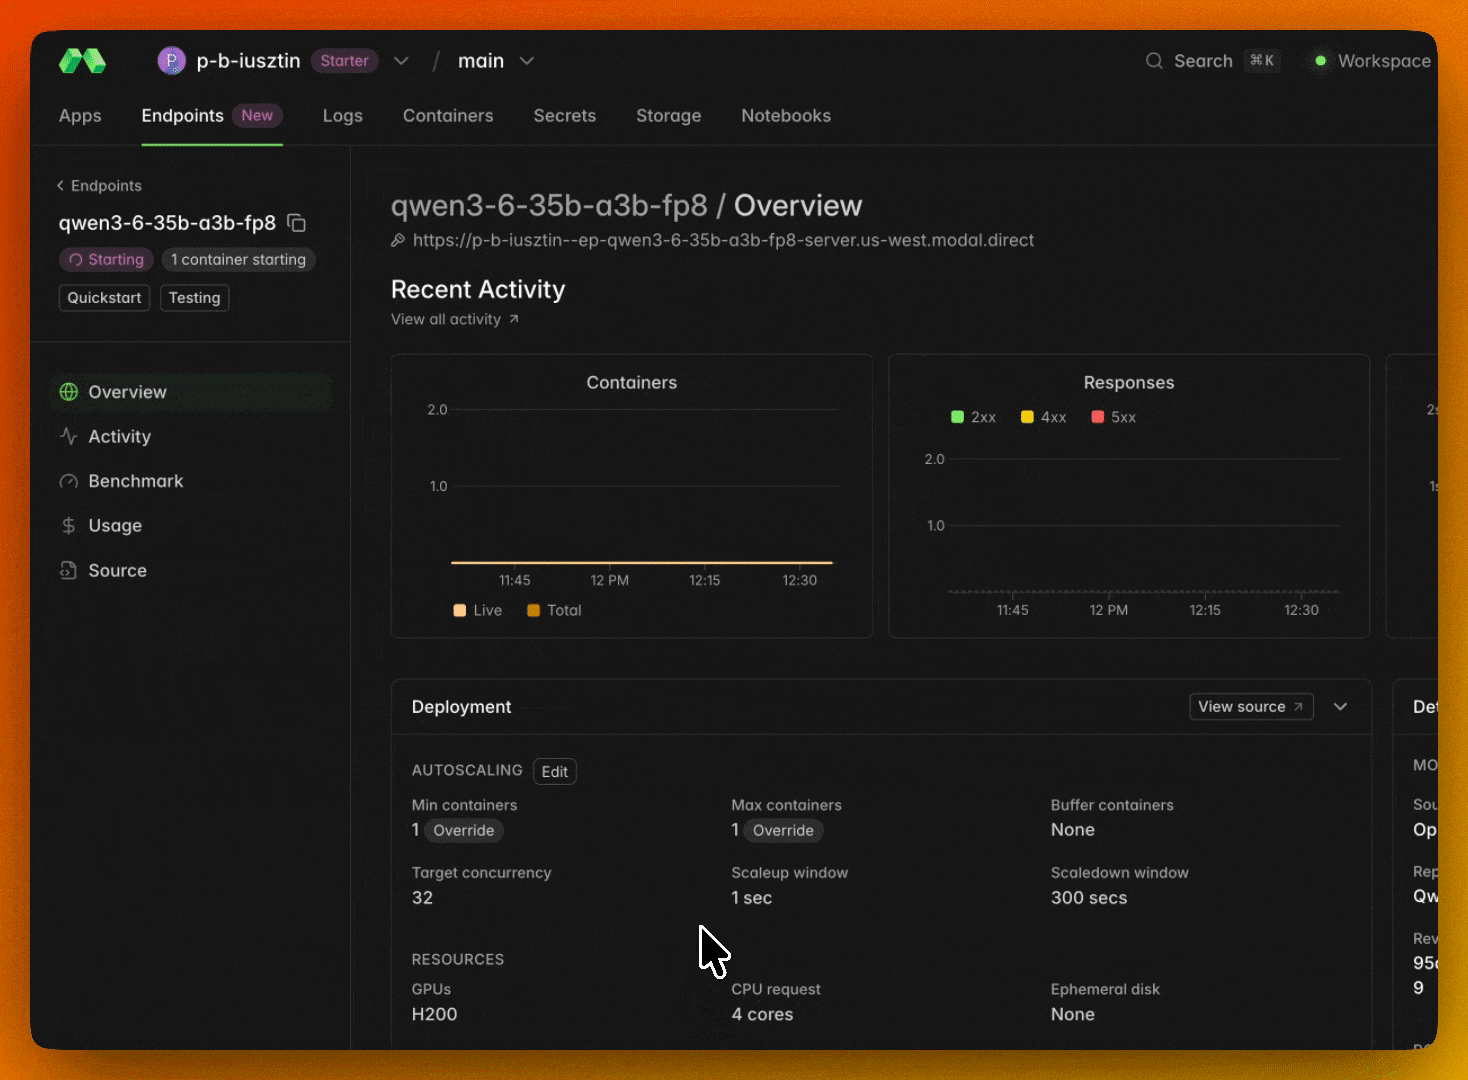
Tự động điều chỉnh quy mô chỉ dành cho bảng điều khiển: Tối thiểu ≥ 1 = giữ ấm (không khởi động nguội, bạn phải trả tiền cho GPU nhàn rỗi); Tối thiểu 0 = tỷ lệ về 0 (yêu cầu đầu tiên sau khi không hoạt động sẽ bắt đầu nguội).
Quản lý
modal endpoint list --env main
modal endpoint stop qwen3-6-35b-a3b-fp8 --env main
Đấu nối điểm cuối vào decode
Điểm cuối tương thích với OpenAI nên nó hoạt động giống nhau OpenAIChatModel đường dẫn là OpenRouter
(ADR-0005): đặt nhà cung cấp thành modal và Đường may của nhà cung cấp (agent/factory._build_model())
xây dựng mô hình từ cài đặt:
LLM_PROVIDER=modal
MODAL_ENDPOINT_URL=https://...                    # used as base_url = {url}/v1
MODAL_ENDPOINT_MODEL=Qwen/Qwen3.6-35B-A3B-FP8     # served model id — course default
MODAL_PROXY_TOKEN_ID=wk-...                       # optional — omit if --unauthenticated
MODAL_PROXY_TOKEN_SECRET=ws-...
Sắc thái xác thực: Proxy của Modal sử dụng tùy chỉnh Modal-Key / Modal-Secret tiêu đề, không phải Ủy quyền: Người mang. Cả hai token proxy được đặt → được gửi dưới dạng tiêu đề mặc định; không được đặt → không có tiêu đề và phần giữ chỗ
api_key="EMPTY". Người bảo vệ khởi động thực thi cả hai hoặc không, vì vậy cặp nửa tập hợp là thân thiện
lỗi cấu hình, không phải lỗi 401 im lặng.
Di chuyển lên bậc thang tốn hai bình env. Bởi vì mọi tùy chọn ở đây đều phục vụ như nhau
Bề mặt tương thích với OpenAI, đi từ mặc định Qwen sang GPT-OSS hoặc GLM-5.2 có nghĩa là trỏ
MODAL_ENDPOINT_URL / MODAL_ENDPOINT_MODEL ở điểm cuối khác — không thay đổi harness, không mã
thay đổi. Xây dựng theo mặc định, sau đó trỏ lại vào mô hình lớn hơn khi bạn muốn xem khoảng cách
cùng một vòng lặp đi.
Giết chết bắt đầu trong khi bạn làm việc
Trên cài đặt tự động điều chỉnh tỷ lệ mặc định (Tối thiểu 0), điểm cuối sẽ chia tỷ lệ về 0 giữa các phiên, do đó yêu cầu đầu tiên sau một khoảng thời gian không hoạt động sẽ chờ GPU hoạt động. Đó là mặc định phù hợp cho một mẫu bạn thỉnh thoảng chạm vào — và mẫu sai khi bạn lặp lại trên harness, nơi nó hiển thị dưới dạng một khoảng dừng dài ở lượt đầu tiên của mỗi phiên.
Cách khắc phục là một cài đặt trang tổng quan: đặt số lượng vùng chứa tối thiểu thành 1 để vùng chứa vẫn được giữ nguyên ấm áp và mỗi lượt trả lời ngay lập tức. Tính năng tự động điều chỉnh tỷ lệ chỉ dành cho bảng điều khiển (không phải là điểm cuối phương thức create` flag) — mở điểm cuối, sau đó TỰ ĐỘNG TÍNH TOÁN → Chỉnh sửa → Ghi đè:
Một thùng chứa ấm cũng tính phí cho thời gian nhàn rỗi. Đó là toàn bộ giao dịch: bạn đang trả tiền theo giờ GPU
để không chờ đợi. Giữ Min 1 cho phiên làm việc, sau đó đặt về 0 — hoặc dừng điểm cuối
hoàn toàn (uv run modal endpoint stop <endpoint-id> --env main) - khi bạn hoàn thành, vì vậy
buổi chiều không viết mã không lặng lẽ chi 30$.