docs/en/s05-context-compression.mdXem bản gốc Bản dịch đầy đủ theo đúng cấu trúc tài liệu; code, liên kết và định danh kỹ thuật được giữ nguyên.
s05: Nén ngữ cảnh
s00 > s01 > s02 > s03 > s04 > [ s05 ] > s06 > s07 > s08 > s09 > s10 > s11 > s12 > s13 > s14 > s15 > s16 > s17 > s18 > s19 > s20 > s21 > s22 > s23 > s24 > s25 > s26 > s27
Thêm ngữ cảnh không phải lúc nào cũng tốt hơn. Điều quan trọng là giữ "các bộ phận vẫn còn hữu ích" trên bề mặt làm việc đang hoạt động.
Chương này giải quyết vấn đề gì
Bởi s04, agent có thể gọi các công cụ, duy trì phiên và tập hợp các lời nhắc.
Chính xác là vì bây giờ nó làm được nhiều việc hơn nên bối cảnh sẽ hiện ra nhanh hơn:
- Đọc một tập tin lớn chứa nhiều văn bản
- Chạy lệnh dài tạo ra kết quả lớn
- Sau nhiều lần gọi tool, kết quả cũ chồng chất
Nếu không có cơ chế nén, những vấn đề này sẽ xuất hiện nhanh chóng:
- Sự chú ý của model bị nhấn chìm bởi kết quả cũ
- Yêu cầu API ngày càng nặng hơn và đắt hơn
- Cuối cùng, giới hạn ngữ cảnh đã đạt đến và nhiệm vụ bị phá vỡ
Vì vậy, điều mà chương này thực sự giải quyết là:
Cách giải phóng không gian trong ngữ cảnh đang hoạt động mà không làm mất tính liên tục của công việc.
Giải thích các thuật ngữ chính
Cửa sổ ngữ cảnh là gì
Hãy nghĩ về cửa sổ ngữ cảnh như sau:
Tổng công suất đầu vào mà mô hình thực tế có thể nhìn thấy trong một lượt.
Nó không phải là vô hạn. Ví dụ: 200K token.
Bối cảnh hoạt động là gì
Không phải mọi thứ đã từng xuất hiện trong lịch sử đều cần phải luôn ở trong cửa sổ.
Bối cảnh hoạt động giống như:
Phần đáng xem nhất hiện nay là đưa ra mô hình để tiếp tục làm việc.
nén là gì
Nén ở đây không phải là nén file ZIP.
Nó có nghĩa là:
Trình bày thông tin dưới dạng ngắn hơn trong khi vẫn giữ được những gì thực sự cần thiết để tiếp tục làm việc.
Mô hình tinh thần tối thiểu
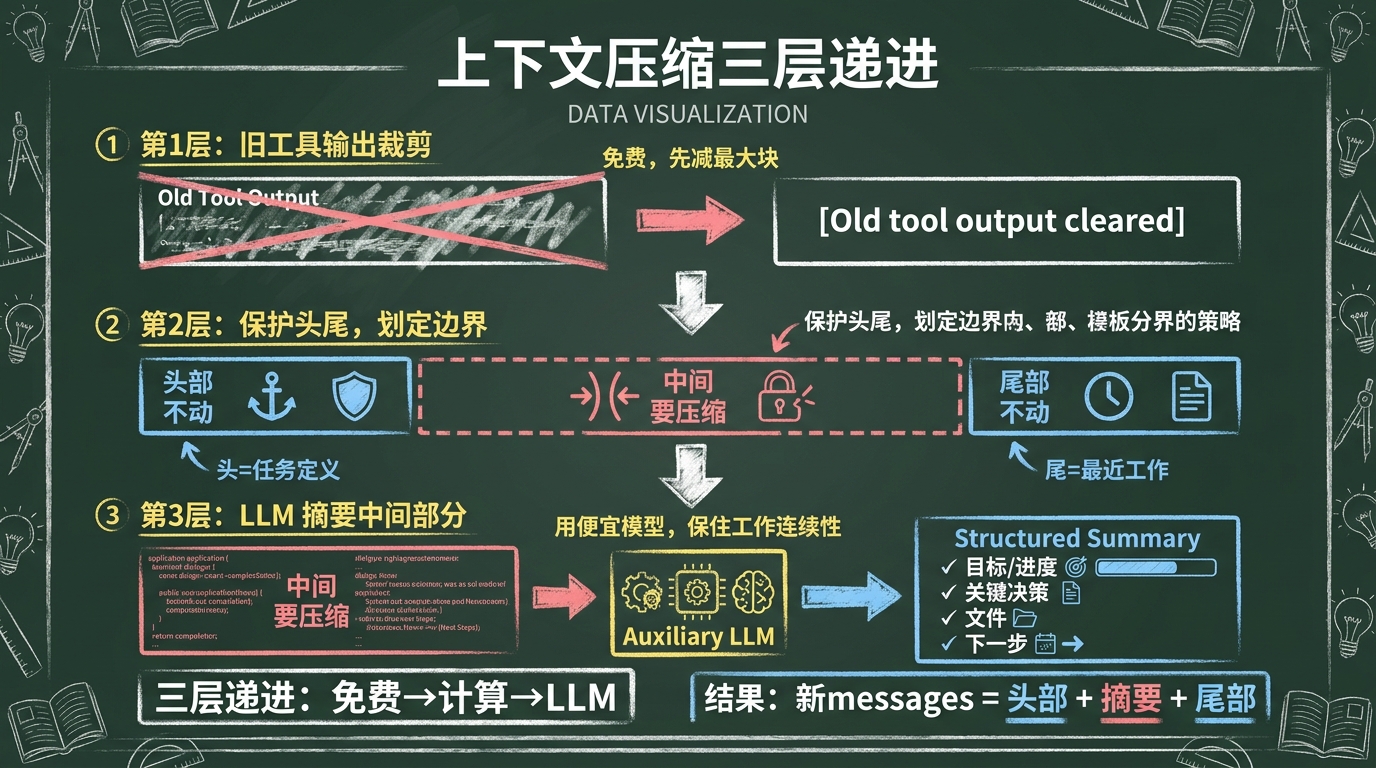
Đối với chương này, hãy bắt đầu bằng cách ghi nhớ ba lớp -- đừng cố gắng ghi nhớ toàn bộ thuật toán trước:
Layer 1: Trim old tool outputs first
  -> No LLM needed, pure string replacement
  -> Replace long-ago tool results with a placeholder

Layer 2: Protect head and tail, compress only the middle
  -> Head (task definition) stays untouched
  -> Tail (recent work) stays untouched
  -> Only compress middle turns that have already been "consumed"

Layer 3: Summarize the middle section with an LLM
  -> Call a cheap auxiliary model
  -> Generate a structured summary to replace the original text
Trực quan hóa:
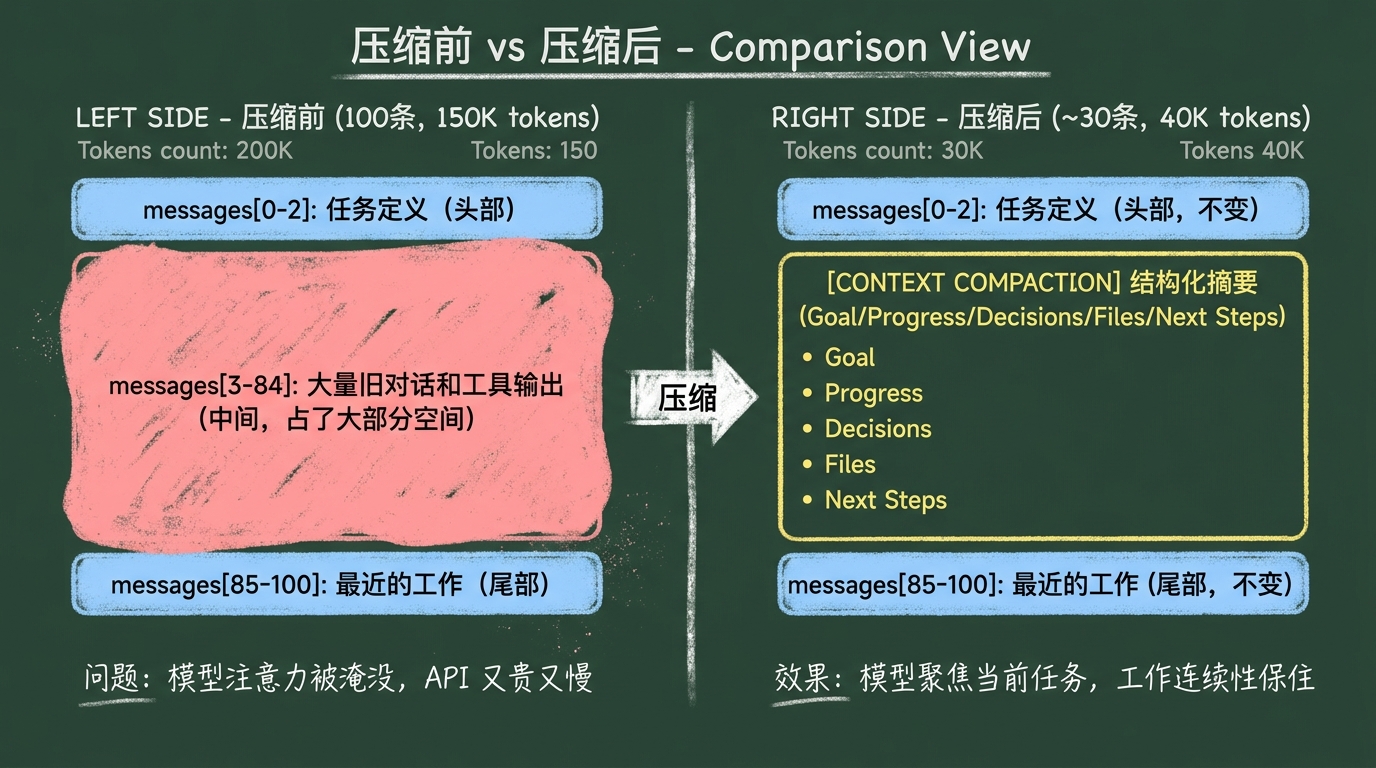
messages (100 items, 150K tokens)
   |
   +-- Layer 1: old tool results -> "[Old tool output cleared]"
   |   (No LLM needed; sheds a batch of tokens upfront)
   |
   +-- Still too long?
   |
   +-- Layer 2: find boundaries
   |   Head: first N messages (untouched)
   |   Tail: most recent ~20K tokens (untouched)
   |   Middle: the part to be compressed
   |
   +-- Layer 3: middle section -> auxiliary LLM -> structured summary
   |
   v
new messages = [head] + [summary] + [tail]
Ba lớp này mang tính lũy tiến: Lớp 1 là rẻ nhất (miễn phí), Lớp 2 là phép tính ranh giới và Lớp 3 là nơi LLM thực sự được gọi.
Những gì phải tồn tại nén
Đây là nơi chương dễ vẫy tay nhất.
Nén không chỉ đơn giản là "rút ngắn lịch sử". Điều thực sự quan trọng là:
Cho phép mô hình tiếp tục hoạt động ở nơi nó đã dừng lại.
Một bản tóm tắt thích hợp phải bảo tồn ít nhất những điều sau:
- Mục tiêu của nhiệm vụ hiện tại là gì
- Những hành động chính nào đã được hoàn thành
- Những quyết định quan trọng nào đã được đưa ra
- Những tập tin nào đã được sửa đổi hoặc kiểm tra chặt chẽ
- Bước tiếp theo nên làm gì
Nếu những thứ này bị mất, quá trình nén sẽ giải phóng không gian nhưng sẽ phá vỡ tính liên tục.
agent Hermes sử dụng mẫu tóm tắt có cấu trúc để đảm bảo thông tin này được lưu giữ:
## Goal
...
## Progress
...
## Key Decisions
...
## Files Modified
...
## Next Steps
...
Không phải văn bản dạng tự do mà là một định dạng xác định. Điều này giúp mô hình trích xuất thông tin chính từ bản tóm tắt dễ dàng hơn nhiều.
Cấu trúc dữ liệu chính
1. Giữ chỗ đầu ra công cụ
các content các thông báo công cụ cũ được thay thế bằng:
[Old tool output cleared to save context space]
Đây là Lớp 1. Không cần LLM, thay thế chuỗi thuần túy, nhưng nó có thể loại bỏ một số lượng lớn token trả trước (đầu ra của công cụ thường dài dòng).
2. Ranh giới nén
{
    "head_end": 3,        # First 3 messages stay untouched
    "tail_start": 85,     # From message 85 onward is the tail, stays untouched
    "middle": [3:85],     # These in the middle are to be compressed
}
Phần đuôi không phải là "N tin nhắn cuối cùng" cố định -- nó được tính theo ngân sách token (khoảng 20 nghìn token). Điều này giữ cho thông tin được bảo quản gần như ổn định bất kể các tin nhắn gần đây dài hay ngắn.
3. Thông báo tóm tắt sau nén
{
    "role": "assistant",
    "content": "[CONTEXT COMPACTION - system-generated summary of earlier "
               "turns, not a new instruction]\n\n"
               "## Goal\n...\n## Progress\n...\n## Key Decisions\n..."
}
Hàng chục tin nhắn ở giữa được thay thế bằng bản tóm tắt duy nhất này.
Lưu ý rằng role là assistant, không user: a userThông báo nén -role sẽ được mô hình đọc là "người dùng vừa nói điều này" và kích hoạt kế hoạch mới -- thường khiến agent làm lại công việc đã hoàn thành. Ghép nối assistant vai trò rõ ràng [CONTEXT COMPACTION - system-generated] tiền tố là sự lựa chọn ổn định.
Thực hiện tối thiểu
Bước 1: Cắt đầu ra của công cụ cũ trước
def prune_old_tool_results(messages, keep_recent=3):
    tool_indices = [i for i, m in enumerate(messages) if m.get("role") == "tool"]
    for idx in tool_indices[:-keep_recent]:
        messages[idx] = {**messages[idx], "content": "[Old tool output cleared]"}
    return messages
Ý tưởng chính đằng sau bước này:
Đầu ra của công cụ thường dài, nhưng đối với công việc tiếp theo, bạn chỉ cần biết "cái gì được gọi và đại khái điều gì đã xảy ra." Không cần LLM -- hãy cắt bớt những chiến thắng dễ dàng nhất trước tiên.
Bước 2: Tìm ranh giới nén
def find_boundaries(messages, protect_first, tail_token_budget):
    head_end = protect_first

    # Count backward from the end, accumulating up to tail_token_budget
    tail_start = len(messages)
    tail_tokens = 0
    for i in range(len(messages) - 1, head_end - 1, -1):
        msg_tokens = len(str(messages[i].get("content", ""))) // 4
        if tail_tokens + msg_tokens > tail_token_budget:
            break
        tail_tokens += msg_tokens
        tail_start = i

    return head_end, tail_start
Ý tưởng chính đằng sau bước này:
Bảo vệ phần đầu (xác định nhiệm vụ) và bảo vệ phần đuôi (công việc gần đây). Chỉ nén ở giữa.
Bước 3: Tóm tắt bằng LLM phụ trợ
def summarize_middle(turns, previous_summary=None):
    prompt = "Summarize these conversation turns.\n"
    prompt += "Use sections: Goal, Progress, Key Decisions, Files Modified, Next Steps.\n\n"

    if previous_summary:
        prompt += f"Previous summary to update:\n{previous_summary}\n\n"

    for msg in turns:
        prompt += f"[{msg['role']}] {str(msg.get('content', ''))[:500]}\n"

    return call_auxiliary_llm(prompt)  # Use a cheap model, not the main one
Hai điểm quan trọng:
- Sử dụng mẫu phụ (rẻ, nhanh), không dùng mẫu chính. Nén là một hoạt động của hệ thống và không nên tiêu tốn ngân sách của mô hình đắt tiền.
- Nếu bản nén trước đó tồn tại, hãy chuyển vào bản tóm tắt cũ. Bản tóm tắt mới trở thành "bản cập nhật cho bản tóm tắt cũ" thay vì "được viết từ đầu", làm mất ít thông tin hơn.
Bước 4: Lắp ráp
def compress(messages, protect_first, tail_token_budget):
    messages = prune_old_tool_results(messages)
    head_end, tail_start = find_boundaries(messages, protect_first, tail_token_budget)

    middle = messages[head_end:tail_start]
    summary = summarize_middle(middle)

    return (
        messages[:head_end]
        + [{"role": "user", "content": f"[CONTEXT COMPACTION]\n{summary}"}]
        + messages[tail_start:]
    )
Bước 5: Móc vào vòng lặp chính
# At the top of the loop in run_conversation()
if estimate_tokens(messages) >= threshold:
    messages = compress(messages, protect_first=3, tail_token_budget=20000)
Bắt đầu từ chương này, vòng lặp chính không còn chỉ là "gọi mô hình + chạy công cụ". Nó đảm nhận thêm một trách nhiệm: quản lý ngân sách bối cảnh hoạt động.
Lựa chọn thiết kế độc đáo của agent Hermes tại đây
1. Nén trước khi bay
run_conversation() kiểm tra số lượng token trước khi vào vòng lặp chính. Nếu số lượng đã vượt quá giới hạn (ví dụ: người dùng đã chuyển từ mô hình cửa sổ lớn sang mô hình cửa sổ nhỏ), quá trình nén sẽ diễn ra trước lệnh gọi API đầu tiên.
Đừng đợi API trả về lỗi. Phòng thủ chủ động tốt hơn phục hồi phản ứng.
2. Nén kích hoạt chia phiên
Sau khi nén, một phiên mới được tạo với parent_session_id trỏ đến phiên cũ (xem s03). Toàn bộ lịch sử của phiên cũ không bao giờ bị xóa và có thể được truy tìm thông qua chuỗi.
3. Xây dựng lại lời nhắc hệ thống
Sau khi nén, lời nhắc hệ thống được lưu trong bộ nhớ đệm sẽ không còn hiệu lực (vì bộ nhớ có thể đã thay đổi) và cần được tập hợp lại. Đây là ngoại lệ đối với s04 cơ chế bộ nhớ đệm nhanh chóng.
4. Căn chỉnh ranh giới ngăn chặn các cuộc gọi tool_call mồ côi
assistant.tool_calls và của họ tool các phản hồi phải được ghép nối -- việc bỏ đi phản hồi trước trong khi thu gọn phản hồi sau khiến yêu cầu API tiếp theo không thành công hoàn toàn.
Thay vì dọn dẹp trẻ mồ côi sau sự việc, find_boundaries nắm bắt cả hai điểm cắt được đề xuất về phía trước bất kỳ tool tin nhắn:
def _align_to_assistant_boundary(messages, index):
    while index < len(messages) and messages[index].get("role") == "tool":
        index += 1
    return index
Khi ranh giới chạm vào một công cụ, vòng lặp sẽ tiến về phía trước cho đến khi chạm vào trợ lý. Do đó, lát giữa được nén luôn là một chuỗi hoàn chỉnh assistant ↔ tool nhóm -- trẻ mồ côi là không thể bằng cách xây dựng.
5. Phát hiện quá trình nén bị kẹt thay vì lặp lại mãi mãi
Trong trường hợp cực đoan, chỉ riêng phần đầu đã tiêu tốn phần lớn ngân sách (ví dụ: tin nhắn đầu tiên của người dùng là một tài liệu khổng lồ). Quá trình nén không còn gì để hoạt động và việc chạy lại hết vòng này đến vòng khác là công việc lãng phí. compress đo lường ước tính token trước/sau và tăng CompressionStuckError nếu độ co giảm xuống dưới 10%:
class CompressionStuckError(RuntimeError):
    """Compress couldn't meaningfully shrink the message list."""

# in compress():
after = estimate_tokens(new_messages)
if after >= int(before * COMPRESSION_MIN_SHRINK):
    raise CompressionStuckError(before, after)
Vòng lặp chính nắm bắt điều này và thoát khỏi lượt hiện tại một cách rõ ràng ("ngữ cảnh không thể được nén thêm - bắt đầu một phiên mới") thay vì nghiền nát cho đến khi MAX_ITERATIONS. Điều này trực tiếp giải quyết báo cáo của vấn đề số 2 rằng quá trình nén "tiếp tục lặp và không bao giờ kết thúc".
Chỉ tóm tắt thôi là chưa đủ: trạng thái nhiệm vụ là lớp không thể nén được
Ba lớp trên (cắt tỉa, tìm ranh giới, tóm tắt) giải quyết vấn đề "thu hẹp bối cảnh hoạt động về mặt vật lý". Nhưng có một loại vấn đề mà không có bản tóm tắt nào, dù được viết hay đến đâu, cũng có thể khắc phục được:
Chế độ xem của mô hình về mục tiêu và tiến độ hiện tại phải không bị mất.
Hãy xem xét tình huống từ vấn đề số 2: người dùng nói "đọc tất cả các tệp trong agent/". agent gọi read_file lặp đi lặp lại, đóng gói nội dung của từng tệp vào ngữ cảnh. Đến tệp thứ 4 hoặc thứ 5, ngưỡng nén bị ngắt và hàng chục kết quả đầu ra của dao được gộp lại thành một bản tóm tắt:
Goal: Read all files under agents/
Progress: Read a few files
Files Modified: none
Next Steps: Keep reading the rest
Tóm tắt là mất mát. Nó không liệt kê những tập tin còn lại. Nó lặng lẽ chuyển "đọc s01, s02" thành "đọc một vài tệp". Ở lần nén tiếp theo, bản tóm tắt đó sẽ được tóm tắt lại -- entropy giảm theo cấp số nhân. Mô hình buộc phải lập kế hoạch lại từ một ảnh chụp nhanh mơ hồ và thường đọc lại các tệp mà nó đã đọc. Đây chính xác là hiện tượng "cứ nén, cứ lặp" mà khách hàng đã báo cáo.
Giải pháp: nâng trạng thái tác vụ ra khỏi luồng tin nhắn
Giới thiệu một TaskState:
@dataclass
class TaskState:
    goal: str = ""
    todos: list[dict] = field(default_factory=list)
    # each todo: {"id", "subject", "status": pending|in_progress|completed}
Các đặc tính quan trọng của nó:
- Nó không sống ở
messages-- thuật toán nén không thể nhìn thấy và không bao giờ chạm vào nó. - Trước mỗi lệnh gọi API,
task_state.render()được thêm vào dấu nhắc hệ thống. Mô hình nhìn thấy toàn bộ mục tiêu và danh sách TODO ở mỗi lượt. - agent duy trì nó thông qua ba công cụ:
task_set_goal(goal)-- ghi lại mục tiêu khi bắt đầu nhiệm vụtodo_write(items)-- trình bày các bước (tự động điền id bị thiếu và trạng thái mặc định)todo_update(id, status)-- lật trạng thái của một bước khi công việc tiến triển
Một lệnh ngắn trong dấu nhắc hệ thống (TASK_TOOLS_GUIDANCE) cho mô hình biết "đối với các tác vụ nhiều bước, hãy liệt kê TODO trước khi làm việc".
Những gì render() tạo ra
# Task State (live, never compressed)

## Goal
Read all files under agents/

## TODO
[x] (t1) list agents directory
[x] (t2) read s01_agent_loop.py
[~] (t3) read s02_tool_system.py
[ ] (t4) read s03_session_store.py
...
[x] / [~] / [ ] là các điểm đánh dấu trực quan cho việc hoàn thành/in_progress/đang chờ xử lý. Nhìn vào khối này, model biết "bước tiếp theo là t4" mà không cần phải tìm hiểu tóm tắt trong lịch sử tin nhắn.
Tại sao điều này hoạt động
Bối cảnh hiện được chia thành hai lớp với các đảm bảo khác nhau:
| Lớp | Đảm bảo | Được duy trì bởi | Nén chạm vào nó? |
|---|---|---|---|
| Luồng tin nhắn | Mất mát | Đầu ra mô hình | Có, theo ngân sách token |
| Trạng thái nhiệm vụ | Mất mát | agent thông qua các công cụ rõ ràng | Không bao giờ |
Bản tóm tắt vẫn hoạt động hữu ích -- nó cho mô hình biết "đại khái là những gì đã xảy ra ở giữa" -- nhưng nó không còn chịu trách nhiệm nặng nề về "tính liên tục của nhiệm vụ", nhiều hơn những gì bản tóm tắt LLM một lần có thể cung cấp.
Lưu ý: TaskState khác với
s07hệ thống bộ nhớ. Bộ nhớ có tính bền bỉ trong nhiều phiên (tùy chọn của người dùng, dữ kiện dài hạn). TaskState nằm trong một tác vụ, chỉ tồn tại trong phiên hoạt động.
Những lỗi thường gặp của người mới bắt đầu
1. Nén suy nghĩ có nghĩa là xóa bỏ
Nó không. Chính xác hơn, tính năng nén sẽ thay thế nội dung "không cần nằm trong ngữ cảnh hoạt động" bằng một cách trình bày khác. Lịch sử cũ được bảo tồn thông qua chuỗi phiên.
2. Chỉ xử lý giới hạn sau khi chạm giới hạn
Cách tiếp cận tốt hơn là chia thành ba lớp lũy tiến: trước tiên hãy cắt bớt các đầu ra cũ, tìm ranh giới rồi tóm tắt. Đừng nhảy thẳng vào việc gọi LLM.
3. Viết một bản tóm tắt không có gì hữu ích
Nếu bản tóm tắt không bảo toàn được mục tiêu, quyết định, hồ sơ và các bước tiếp theo thì việc tiếp tục công việc sẽ vô ích.
4. Sử dụng mô hình chính để tóm tắt
Nén là một hoạt động của hệ thống, không phải là yêu cầu của người dùng. Một mô hình phụ trợ giá rẻ là đủ.
5. Không bảo vệ đuôi
Nếu các tin nhắn gần đây nhất cũng bị nén, agent sẽ ngay lập tức quên đi những gì nó vừa làm.
6. Để bản tóm tắt mang lại tiến độ công việc
Đây là nguyên nhân cốt lõi thực sự của vấn đề số 2: giao "mục tiêu/tiến độ/các bước đang chờ xử lý" -- thông tin liên tục chịu tải -- cho người tóm tắt. Tóm tắt là nén mất dữ liệu. Qua nhiều vòng, những chi tiết đó chắc chắn sẽ bị xói mòn.
Trạng thái tác vụ thuộc bên ngoài luồng tin nhắn, được tổng đài viên duy trì rõ ràng thông qua các công cụ chuyên dụng (task_set_goal / todo_write / todo_update) và hiển thị lại vào dấu nhắc hệ thống mỗi lượt. Bản tóm tắt chỉ nên mang những gì nó có thể mang: "những gì đã xảy ra ở giữa" như một phần bổ sung.
Ranh giới giảng dạy
Chương này không nên trượt vào "bộ bách khoa toàn thư về tất cả các kỹ thuật nén".
Phiên bản giảng dạy bao gồm bốn điều rõ ràng:
- Cắt đầu ra của công cụ cũ trước (miễn phí)
- Bảo vệ đầu và đuôi, căn chỉnh theo ranh giới trợ lý, chỉ nén phần giữa
- Sử dụng LLM phụ trợ để tạo bản tóm tắt có cấu trúc -- "bản ghi nhớ ở giữa"
- Nâng cao mục tiêu + tiến tới Trạng thái nhiệm vụ nằm ngoài các thông điệp, như một nguồn sự thật không mất mát
Trì hoãn có chủ ý: đếm token chính xác, chiến lược nén lặp nhiều lượt, nén thụ động được kích hoạt do lỗi API (-> s06), tính bền vững giữa các phiên (-> s07).
Nếu người đọc có thể yêu cầu agent "tự động nén phần giữa khi cuộc trò chuyện vượt quá ngưỡng, giữ nguyên phần đầu và phần đuôi, giữ phần tóm tắt làm bản ghi nhớ ở giữa và để TaskState giữ mục tiêu và tiến trình", thì chương này đã đạt được mục tiêu.
Một dòng cần nhớ
Cốt lõi của việc nén ngữ cảnh không phải là giảm thiểu độ dài văn bản mà là cho phép mô hình duy trì tính liên tục của công việc trong ngữ cảnh hoạt động ngắn hơn.