docs/en/s25-skill-evolution.mdXem bản gốc Bản dịch đầy đủ theo đúng cấu trúc tài liệu; code, liên kết và định danh kỹ thuật được giữ nguyên.
s25: Tổng quan về tiến hóa kỹ năng
s00 > s01 > s02 > s03 > s04 > s05 > s06 > s07 > s08 > s09 > s10 > s11 > s12 > s13 > s14 > s15 > s16 > s17 > s18 > s19 > s20 > s21 > s22 > s23 > s24 > [ s25 ] > s26 > s27
s23 tự cải thiện mô hình thông qua đào tạo. s25-s27 thực hiện một cách tiếp cận khác -- họ giữ nguyên mô hình và chỉ thay đổi văn bản mà nó nhận được. Hướng dẫn kỹ năng, mô tả công cụ, lời nhắc hệ thống, thậm chí cả mã công cụ -- tất cả đều là văn bản và tất cả đều có thể được tối ưu hóa một cách có hệ thống.
Chương này giải quyết vấn đề gì
Hãy lùi lại và nhìn vào bức tranh lớn.
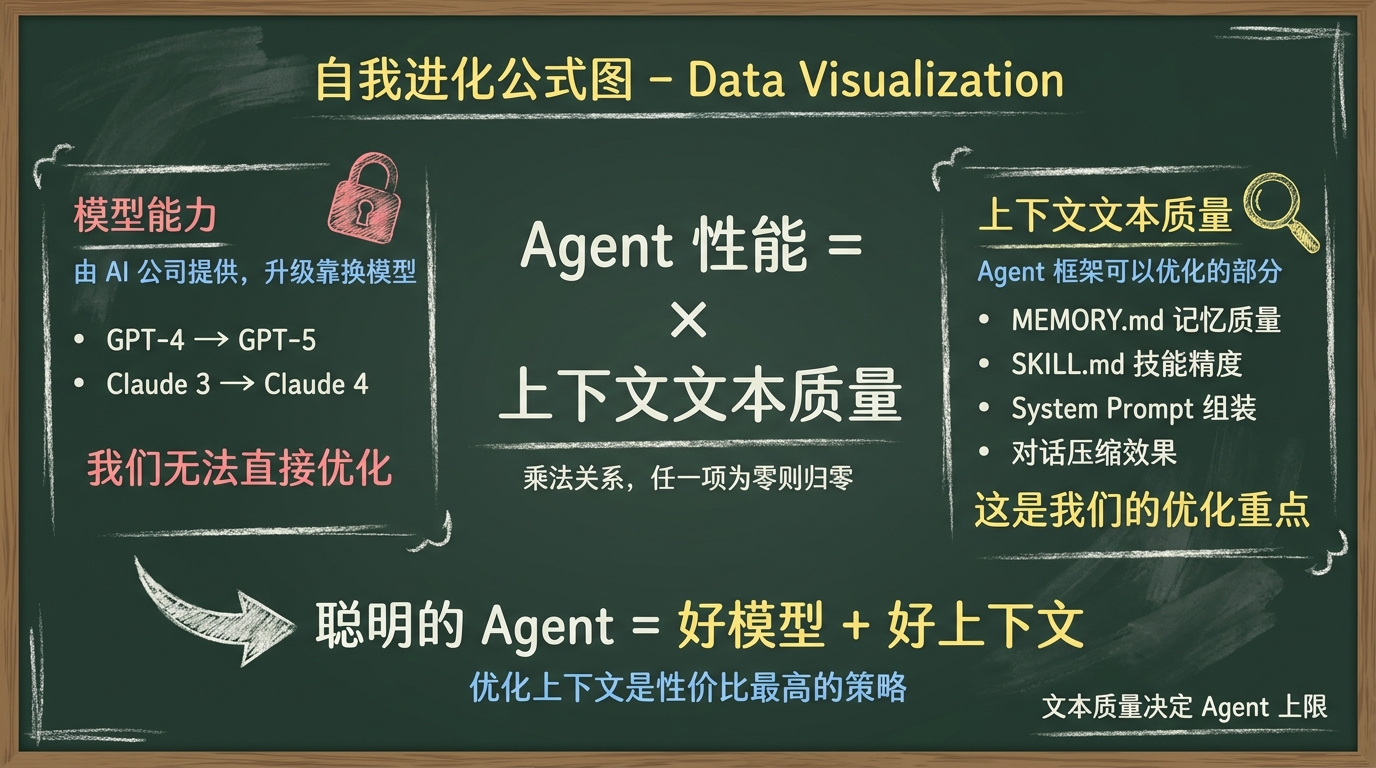
Mọi thứ nhân viên nhận được trong runtime -- lời nhắc hệ thống, hướng dẫn kỹ năng, mô tả công cụ -- đều là văn bản. Hiệu suất của agent được xác định bởi hai yếu tố:
agent performance = model capability x context text quality
s23 giải quyết phần bên trái của phương trình này: khả năng của mô hình (đào tạo RL, yêu cầu GPU, chi phí cao).
Nhưng còn phía bên phải -- chất lượng văn bản ngữ cảnh thì sao? Các kỹ năng được tạo tự động trong s21 có thể chưa tốt; mô tả công cụ do con người viết có thể sử dụng từ ngữ không chính xác khiến mô hình chọn sai công cụ; hướng dẫn hành vi trong lời nhắc hệ thống có thể không rõ ràng.
Những văn bản này ảnh hưởng trực tiếp đến hiệu suất của tổng đài viên nhưng chúng chưa bao giờ được kiểm tra hoặc cải tiến một cách có hệ thống.
Đây chính xác là điều mà quá trình phát triển kỹ năng của agent Hermes giải quyết: vòng lặp "điểm -> viết lại -> chọn kết quả tốt nhất" giúp tối ưu hóa một cách có hệ thống tất cả văn bản mà agent nhận được.
Thuộc tính chính:
- Không cần đào tạo mô hình, không cần GPU
- Chi phí cực thấp: ~$2-10 cho mỗi lần chạy tối ưu hóa
- Có hiệu lực ngay: sau khi văn bản được cập nhật, cuộc trò chuyện tiếp theo sẽ sử dụng phiên bản mới
Đề xuất đọc
s08-skill-system.md-- Kỹ năng cơ bản: định dạng, khám phá, tảis21-skill-creation-loop.md-- Kỹ năng được tạo ra như thế nàos23-trajectory-and-rl.md-- So sánh đào tạo ngoại tuyến và tối ưu hóa văn bản
Điều khoản chính
Tối ưu hóa văn bản là gì
Thay vì thay đổi trọng số của mô hình, bạn chỉ thay đổi văn bản mà mô hình nhận được. Bằng cách thử một cách có hệ thống các phiên bản khác nhau của văn bản, đánh giá kết quả và giữ lại các phiên bản tốt hơn, bạn sẽ cải thiện hiệu suất của nhân viên.
Một sự tương tự: bạn không thay thế đầu bếp (mô hình) -- bạn thay thế công thức (văn bản kỹ năng). Một công thức tốt hơn sẽ giúp cùng một đầu bếp tạo ra những món ăn ngon hơn.
GEPA là gì
Sự tiến hóa nhanh chóng về mặt di truyền-Pareto, một bài báo từ ICLR 2026, được tích hợp vào khung DSPy. Ý tưởng cốt lõi: đọc dấu vết thực thi để hiểu tại sao điều gì đó không thành công (chứ không chỉ là "nó không thành công"), sau đó thực hiện các đột biến văn bản được nhắm mục tiêu.
agent Hermes thực sự sử dụng dspy.GEPA(). Việc triển khai giảng dạy trong các chương sau mô phỏng cùng một ý tưởng theo cách đơn giản nhất có thể -- mà không phụ thuộc vào DSPy.
Nhà tiến hóa Darwin là gì
Một khung dành riêng cho việc phát triển mã (AGPL v3) sử dụng git để quản lý các biến thể mã. Hermes sử dụng nó trong Giai đoạn 4 (tiến hóa mã). Không giống như GEPA, nó hoạt động trên mã nguồn Python thay vì lời nhắc.
Bốn lớp mục tiêu tiến hóa
Tiến hóa kỹ năng không phải là một tính năng nhỏ chỉ giới hạn ở các kỹ năng. Đây là một quy trình tối ưu hóa văn bản có mục đích chung bao gồm bốn loại mục tiêu. Tất cả bốn lớp đều có chung một vòng lặp tối ưu hóa (điểm -> viết lại -> chọn lớp tốt nhất); sự khác biệt nằm ở những gì đang được phát triển và mức độ rủi ro.
Giai đoạn 1: Hồ sơ kỹ năng (Giá trị cao nhất, Rủi ro thấp nhất)
Kỹ năng là những hướng dẫn nhiệm vụ bằng văn bản đơn giản -- "Bước một: làm X. Chú ý Y. Nếu Z thì..."
Tại sao bắt đầu ở đây? Dễ thay đổi (chỉnh sửa khối đánh dấu), dễ đánh giá (yêu cầu agent sử dụng nó trong một nhiệm vụ và xem nó diễn ra như thế nào) và nếu có sự cố xảy ra, chỉ một kỹ năng bị ảnh hưởng.
Động cơ: DSPy + GEPA. Trạng thái: Đã triển khai.
Giai đoạn 2: Mô tả công cụ (Giá trị trung bình, Rủi ro thấp)
Mô tả công cụ xác định "khi mô hình chọn công cụ nào." Ví dụ, nếu mô tả của search_files không đủ rõ ràng, mô hình có thể chọn sai terminal(grep) khi nào nó nên được sử dụng search_files.
Phương pháp tối ưu hóa: tạo một bộ thử nghiệm gồm các cặp "tác vụ -> nên sử dụng công cụ nào", sử dụng GEPA để thay đổi văn bản mô tả và đánh giá xem mô hình có chọn đúng công cụ hay không.
Ràng buộc: mỗi mô tả công cụ không được vượt quá 500 ký tự (lược đồ công cụ đầy đủ được gửi trên mỗi lệnh gọi API).
Động cơ: DSPy + GEPA. Tình trạng: Đã quy hoạch.
Giai đoạn 3: Phần nhắc hệ thống (Giá trị cao, Rủi ro cao)
Hướng dẫn hành vi trong lời nhắc hệ thống -- "thời điểm lưu kỷ niệm", "thời điểm tìm kiếm lịch sử hội thoại". Cải thiện những điều này và hành vi tổng thể của agent sẽ tốt hơn; hiểu sai và mọi cuộc trò chuyện đều bị ảnh hưởng.
Các ràng buộc nghiêm ngặt nhất: mỗi phần không được vượt quá 120% kích thước ban đầu (để ngăn chặn tình trạng phình to ngay lập tức phá vỡ ranh giới bộ đệm) và bắt buộc phải kiểm tra hồi quy điểm chuẩn.
Động cơ: DSPy + GEPA. Tình trạng: Đã quy hoạch.
Giai đoạn 4: Mã triển khai công cụ (Giá trị cao, Rủi ro cao nhất)
Mã Python thực tế. Không giống như ba lớp đầu tiên -- sửa đổi văn bản ngôn ngữ tự nhiên -- lớp này sửa đổi mã.
Những hạn chế khó khăn nhất: bộ thử nghiệm đầy đủ phải đạt 100%, chữ ký hàm không thể thay đổi và registry.register() cuộc gọi không được chạm vào.
Động cơ: Darwinian Evolver (CL bên ngoài). Tình trạng: Đã quy hoạch.
Quy trình hoàn chỉnh: 7 bước
Bất kể lớp nào đang được phát triển, đường ống đều có cấu trúc giống nhau:
+--------------------------------------------------+
|  1. SELECT TARGET                                |
|     Pick a skill / tool desc / prompt to improve |
|                                                  |
|  2. BUILD EVAL DATASET           <- s26 details  |
|     Generate test cases, split train/val/holdout |
|                                                  |
|  3. EVALUATE BASELINE            <- s26 details  |
|     Score the current version with fitness func  |
|                                                  |
|  4. CHECK CONSTRAINTS            <- s26 details  |
|     Does the current version pass constraints?   |
|                                                  |
|  5. OPTIMIZE (repeat N times)    <- s27 details  |
|     Collect feedback -> rewrite -> score -> keep  |
|                                                  |
|  6. VALIDATE EVOLVED             <- s27 details  |
|     Does evolved pass constraints? Holdout score?|
|                                                  |
|  7. DEPLOY                       <- s27 details  |
|     Backup -> write -> auto-active next session  |
|                                                  |
|  Steps 2-4 = "Evaluation System" (s26)           |
|  Steps 5-7 = "Optimization & Deploy" (s27)       |
+--------------------------------------------------+
7 bước này liên hệ trực tiếp tới Hermes' evolve_skill.py.
Kiến trúc Hermes: Repo riêng biệt, hoạt động trên agent
Một quyết định quan trọng về mặt kiến trúc: hệ thống tiến hóa kỹ năng không tồn tại bên trong repository agent Hermes. Nó là một repository riêng (NousResearch/hermes-agent-self-evolution) tác động lên agent Hermes.
hermes-agent-self-evolution/        <- separate repo
├── evolution/
│   ├── core/
│   │   ├── config.py               <- configuration + hermes-agent path discovery
│   │   ├── dataset_builder.py      <- eval dataset generation
│   │   ├── external_importers.py   <- mine data from Claude Code/Copilot/Hermes
│   │   ├── fitness.py              <- fitness function (LLM-as-judge)
│   │   └── constraints.py          <- constraint gating
│   ├── skills/
│   │   ├── skill_module.py         <- wraps SKILL.md as a DSPy module
│   │   └── evolve_skill.py         <- Phase 1 main pipeline
│   ├── tools/                      <- Phase 2 (planned)
│   ├── prompts/                    <- Phase 3 (planned)
│   ├── code/                       <- Phase 4 (planned)
│   └── monitor/                    <- Phase 5 auto-trigger (planned)
├── datasets/                       <- generated eval datasets
└── tests/
Tại sao một repo riêng biệt? Bởi vì quá trình phát triển kỹ năng là công cụ dành cho thời gian phát triển, không phải là tính năng trong runtime. Nó đọc mã và dữ liệu của agent hermes, xuất ra các tệp được cải tiến và gửi chúng qua git PR -- nó không bao giờ chạy trong cuộc trò chuyện của người dùng.
Bắt đầu từ việc thực hiện đơn giản nhất
Một con người chỉnh sửa một kỹ năng theo cách thủ công:
You: [open SKILL.md, read through it]
You: Oh, step 3 is missing error-handling instructions
You: [manually edit SKILL.md]
You: [run a few tests to see if it improved]
Điều này hoạt động. Nhưng có hai vấn đề:
Vấn đề 1: Không có tiêu chí đánh giá định lượng
“Kỹ năng này có tốt không?” là một sự phán xét mơ hồ. Sau khi chỉnh sửa SKILL.md, làm sao bạn biết nó tốt hơn chứ không tệ hơn? Bạn cần đánh giá định lượng chứ không phải trực giác.
-> s26 giải quyết vấn đề này: xây dựng một tập dữ liệu eval + hàm thích nghi + kiểm soát ràng buộc.
Vấn đề 2: Không có chiến lược cải tiến có hệ thống
Ngay cả khi bạn biết điểm thấp, bạn làm cách nào để cải thiện nó? Tinh chỉnh một điều bằng trực giác? Bạn có nên quay lại? Có bao nhiêu vòng chỉnh sửa?
-> s27 giải quyết vấn đề này: thu thập phản hồi -> viết lại có mục tiêu -> ghi điểm -> chọn vòng lặp tốt nhất + quy trình hoàn chỉnh.
Phạm vi của Chương này
Chương này chỉ đề cập đến "tiến hóa kỹ năng là gì, tại sao chúng ta làm điều đó và bức tranh toàn cảnh".
Nó không bao gồm việc triển khai cụ thể -- đó là công việc của s26 (hệ thống đánh giá) và s27 (tối ưu hóa & triển khai).
Chương này là bản đồ; hai chương tiếp theo là cuộc hành trình thực tế.
Xem trước hai chương tiếp theo
| Chương | Câu hỏi cốt lõi | Những gì bạn nhận được |
|---|---|---|
| s26 | Làm thế nào để chúng ta biết nếu nó tốt? | EvalDataset + FitnessScore + ConstraintValidator + dữ liệu đến từ đâu |
| s27 | Làm thế nào để chúng tôi cải thiện và vận chuyển? | SkillOptimizer + hoàn thiện quy trình tiến hóa_skill() + Ứng dụng Giai đoạn 2-4 |
Sau chương này, bạn sẽ có thể trả lời
- Điều gì quyết định năng lực của một agent? Mỗi mô hình và văn bản đóng vai trò gì?
- Tại sao tối ưu hóa văn bản không cần GPU? Nó bổ sung cho việc đào tạo RL như thế nào?
- Bốn lớp mục tiêu tiến hóa là gì? Họ được xếp hạng theo rủi ro như thế nào?
- 7 bước của quy trình hoàn chỉnh là gì? Bước nào thuộc về "đánh giá" và bước nào thuộc về "tối ưu hóa"?
- Tại sao repo tiến hóa kỹ năng lại tách biệt với Hermes-agent? Đây là tính năng runtime hay công cụ thời gian phát triển?
Hãy nhớ một câu: không thay đổi mô hình - hãy thay đổi văn bản. Bốn lớp mục tiêu, một quy trình thống nhất.