docs/en/s20-background-review.mdXem bản gốc Bản dịch đầy đủ theo đúng cấu trúc tài liệu; code, liên kết và định danh kỹ thuật được giữ nguyên.
s20: Đánh giá cơ bản
s00 > s01 > s02 > s03 > s04 > s05 > s06 > s07 > s08 > s09 > s10 > s11 > s12 > s13 > s14 > s15 > s16 > s17 > s18 > s19 > [ s20 ] > s21 > s22 > s23 > s24 > s25 > s26 > s27
Người dùng hiếm khi tự mình nói "hãy nhớ điều này cho tôi". agent cần chú ý những gì đáng ghi nhớ và những gì có thể được chắt lọc thành một kỹ năng -- sau đó lặng lẽ xử lý nó ở chế độ nền mà không làm gián đoạn công việc của người dùng.
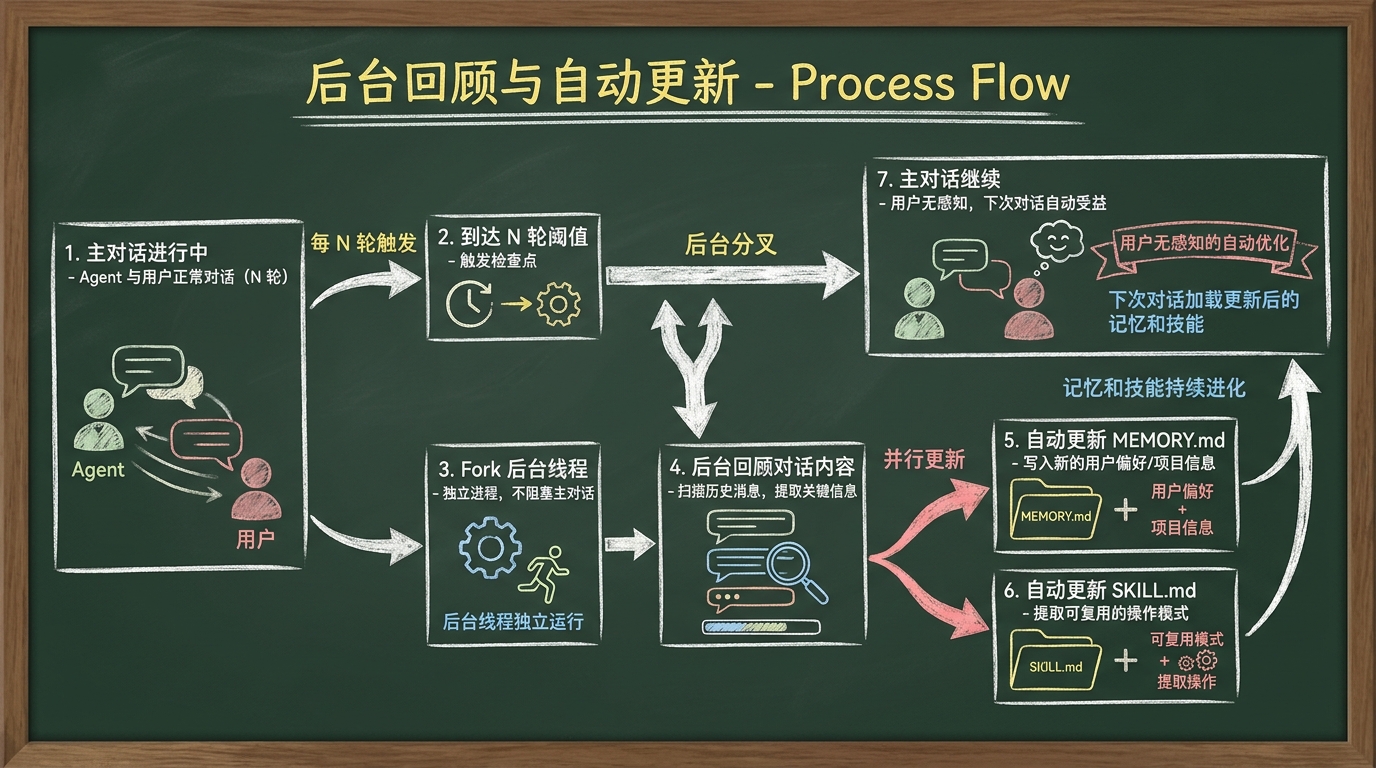
Chương này giải quyết vấn đề gì
s07 bao phủ hệ thống bộ nhớ. s08 bao trùm hệ thống kỹ năng. Nhưng cả hai đều có chung một điều kiện tiên quyết: nhân viên phải chủ động gọi công cụ bộ nhớ hoặc kỹ năng quản lý.
Vấn đề là: khi agent bận giúp đỡ người dùng giải quyết một vấn đề, nó hiếm khi "ngừng suy nghĩ" về việc cập nhật bộ nhớ của mình.
Kịch bản: Một tùy chọn bị bỏ lỡ.
Turn 1: User: Take a look at this Python project for me
Turn 2: Agent: [reads files, analyzes code]
Turn 3: User: By the way, I don't like semicolons at the end of lines, and I don't like type hints
Turn 4: Agent: Got it. [continues analyzing code]
Turn 5: User: Refactor parser.py for me
Turn 6-10: Agent: [refactors files, occasionally still writes type hints]
Người dùng bày tỏ sự ưu tiên ở Lượt 3, nhưng nhân viên đang bận phân tích mã và không nghĩ đến việc gọi memory_tool để lưu trữ nó. Khi cuộc trò chuyện tiếp theo bắt đầu, người đại diện không hề nhớ gì về điều này.
Có đánh giá lý lịch:
After Turn 10 completes -> background thread starts
  The review agent reads the entire conversation history
  Discovers the preference information from Turn 3
  Calls memory_tool to write to USER.md:
    "User dislikes semicolons at end of lines and type hints"
  Completes silently, invisible to the user

Next new conversation -> system prompt already contains this memory
Đây là vấn đề mà Đánh giá cơ bản giải quyết: để nhân viên "nhìn lại" sau khi cuộc trò chuyện kết thúc để nắm bắt kiến thức đã bỏ lỡ trong quá trình làm việc.
Đề xuất đọc
s07-memory-system.md-- Cơ chế đọc/ghi bộ nhớ, được agent đánh giá sử dụng lại trực tiếps08-skill-system.md-- Tạo/chỉnh sửa kỹ năng; agent đánh giá có thể tự động tạo các kỹ năng mớis10-subagent-delegation.md-- Ngược lại: các agent con có tính đồng bộ; quá trình xem xét nền không đồng bộ
Các khái niệm chính
Đánh giá cơ bản là gì
Sau khi tổng đài viên chính kết thúc lượt trò chuyện, nó sẽ khởi chạy phiên bản tổng đài viên độc lập ở chế độ nền, cung cấp toàn bộ lịch sử cuộc trò chuyện và yêu cầu tổng đài viên trả lời một câu hỏi:
"Có điều gì đáng nhớ trong cuộc trò chuyện này không? Có điều gì có thể được chắt lọc thành một kỹ năng không?"
Nếu vậy, agent đánh giá sẽ trực tiếp gọi các công cụ bộ nhớ/kỹ năng để thực hiện cập nhật. Nếu không, nó báo "Không có gì để lưu" và thoát.
Bộ đếm kép là gì
Đánh giá cơ bản sử dụng hai bộ đếm kích hoạt độc lập:
_turns_since_memory-- Mỗi N tin nhắn của người dùng (mặc định là 10), sẽ kích hoạt quá trình xem lại bộ nhớ_iters_since_skill-- Mỗi N lần lặp lệnh gọi công cụ (mặc định là 10), kích hoạt đánh giá kỹ năng
Tại sao lại là hai đơn vị khác nhau?
- Bộ nhớ tập trung vào những gì người dùng nói -> được đo bằng "số lượng tin nhắn người dùng đã gửi"
- Kỹ năng tập trung vào những gì nhân viên đã làm -> được đo bằng "số lượng cuộc gọi công cụ mà nhân viên đã thực hiện"
Một người dùng có thể gửi 10 tin nhắn trong khi tổng đài viên chỉ thực hiện 2 cuộc gọi công cụ (trò chuyện thuần túy) hoặc gửi 1 tin nhắn trong khi tổng đài viên thực hiện 20 cuộc gọi công cụ (nhiệm vụ phức tạp). Hai trường hợp đòi hỏi những hình thức xem xét khác nhau.
agent đánh giá khác với agent phụ như thế nào
Những độc giả đã nghiên cứu hệ thống subagent của s10 có thể hỏi: đây không phải chỉ là tạo ra một agent khác sao?
| agent phụ s10 | Đánh giá lý lịch s20 | |
|---|---|---|
| Mục đích | Hoàn thành một nhiệm vụ phụ cho người dùng | Tự phản ánh; cập nhật bộ nhớ/kỹ năng |
| Thời gian | Trong quá trình thực thi tác vụ của người dùng | Sau khi hoàn thành nhiệm vụ của người dùng |
| Chặn | Đồng bộ, chặn agent gốc | Không đồng bộ, luồng daemon |
| Ngân sách lặp lại | Được chia sẻ với cha mẹ (được sử dụng nhiều hơn = ít hơn đối với cha mẹ) | Ngân sách độc lập (max=8) |
| Điểm đến kết quả | Tóm tắt được trả lại cho phụ huynh -> được đặt trong tin nhắn | Viết trực tiếp vào MEMORY.md / Skills/ |
| Xử lý lỗi | Báo lỗi cho người dùng | Âm thầm nuốt, nỗ lực hết sức |
Điểm khác biệt chính: subagent là phần mở rộng công việc được thực hiện cho người dùng; agent đánh giá là quá trình học tập của chính agent đó.
Mô hình tinh thần tối thiểu
Main agent conversation loop
  |
  |  After each turn, check two counters:
  |    _turns_since_memory >= 10?
  |    _iters_since_skill >= 10?
  |
  |  If either triggers:
  v
_spawn_background_review()
  |
  |  1. Copy messages (snapshot)
  |  2. Choose review prompt (memory / skill / combined)
  |  3. Create new AIAgent(max_iterations=8, nudge_interval=0)
  |  4. Launch daemon thread
  |
  v
Background thread
  |  review_agent.run_conversation(
  |      prompt = "Review this conversation -- anything worth remembering?"
  |      history = messages_snapshot
  |  )
  |
  |  The review agent can call:
  |    - memory_tool -> writes to MEMORY.md / USER.md
  |    - skill_manage -> creates/edits skill files
  |
  |  Exits silently on completion
  |  (Main agent and user are completely unaffected)
  v
MEMORY.md / skills/ updated
  -> Next conversation's system prompt automatically includes new memories/skills
Cấu trúc dữ liệu chính
Xem lại trạng thái kích hoạt
# In AIAgent.__init__
self._turns_since_memory = 0     # User message counter
self._iters_since_skill = 0     # Tool iteration counter
self._memory_nudge_interval = 10 # Trigger threshold (configurable)
self._skill_nudge_interval = 10  # Trigger threshold (configurable)
Xem lại lời nhắc
_MEMORY_REVIEW_PROMPT = (
    "Review the conversation above and consider saving to memory "
    "if appropriate.\n\n"
    "Focus on:\n"
    "1. Has the user revealed things about themselves — their persona, "
    "desires, preferences, or personal details worth remembering?\n"
    "2. Has the user expressed expectations about how you should behave?\n\n"
    "If something stands out, save it using the memory tool. "
    "If nothing is worth saving, just say 'Nothing to save.' and stop."
)

_SKILL_REVIEW_PROMPT = (
    "Review the conversation above and consider saving or updating "
    "a skill if appropriate.\n\n"
    "Focus on: was a non-trivial approach used to complete a task that "
    "required trial and error, or changing course due to experiential "
    "findings along the way?\n\n"
    "If a relevant skill already exists, update it. Otherwise, create "
    "a new skill if the approach is reusable.\n"
    "If nothing is worth saving, just say 'Nothing to save.' and stop."
)
Hãy chú ý đến câu cuối cùng của mỗi lời nhắc: "Nếu không có gì đáng để tiết kiệm, chỉ cần nói 'Không có gì để tiết kiệm'. và dừng lại." Điều này rất quan trọng -- nếu không có nó, người đánh giá sẽ bịa đặt những phát hiện khi không có gì có ý nghĩa để viết.
Thực hiện tối thiểu
Bước 1: Bộ đếm kép
Duy trì hai bộ đếm bên trong vòng lặp chính của run_conversation:
def run_conversation(self, user_message, ...):
    # User message arrives -> increment memory counter
    self._turns_since_memory += 1

    for iteration in range(MAX_ITERATIONS):
        # ... model call ...

        if assistant_msg.tool_calls:
            # Tool call -> increment skill counter
            self._iters_since_skill += 1

            for tool_call in assistant_msg.tool_calls:
                # User explicitly invoked memory/skill -> reset counters
                if tool_call.function.name in ("memory", "skill_manage"):
                    self._turns_since_memory = 0
                    self._iters_since_skill = 0
Tại sao một lệnh gọi rõ ràng lại đặt lại bộ đếm? Nếu người dùng chỉ nói "hãy nhớ rằng tôi không thích gợi ý loại" và agent có tên là Memory_tool, thì không cần phải xem xét lý lịch để giải quyết vấn đề tương tự. Đặt lại bộ đếm sẽ tránh được công việc trùng lặp.
Bước 2: Kiểm tra kích hoạt
Sau khi cuộc trò chuyện kết thúc (trước run_conversation trả về), hãy kiểm tra xem có kích hoạt hay không:
    # run_conversation is about to return
    should_review_memory = (
        self._memory_nudge_interval > 0
        and self._turns_since_memory >= self._memory_nudge_interval
    )
    should_review_skills = (
        self._skill_nudge_interval > 0
        and self._iters_since_skill >= self._skill_nudge_interval
    )

    if should_review_memory or should_review_skills:
        self._turns_since_memory = 0
        self._iters_since_skill = 0
        self._spawn_background_review(
            messages_snapshot=list(messages),  # snapshot copy
            review_memory=should_review_memory,
            review_skills=should_review_skills,
        )

    return {"final_response": ..., "messages": messages}
Bước 3: Thực thi luồng nền
def _spawn_background_review(self, messages_snapshot, review_memory, review_skills):
    # Choose prompt
    if review_memory and review_skills:
        prompt = _COMBINED_REVIEW_PROMPT
    elif review_memory:
        prompt = _MEMORY_REVIEW_PROMPT
    else:
        prompt = _SKILL_REVIEW_PROMPT

    def _run_review():
        import contextlib

        # Review agent: independent instance, shared MemoryStore
        review_agent = create_review_agent(
            parent=self,
            max_iterations=8,
        )

        # Silent execution: stdout/stderr -> /dev/null
        with open(os.devnull, "w") as devnull, \
             contextlib.redirect_stdout(devnull), \
             contextlib.redirect_stderr(devnull):
            try:
                review_agent.run_conversation(
                    user_message=prompt,
                    history=messages_snapshot,
                )
            except Exception:
                pass  # best-effort: review failure doesn't affect the user

    # daemon=True: thread auto-terminates when main process exits
    thread = threading.Thread(target=_run_review, daemon=True,
                              name="bg-review")
    thread.start()
Bước 4: Tạo agent đánh giá (Chia sẻ so với Cô lập)
def create_review_agent(parent, max_iterations=8):
    """Create an isolated agent instance for background review."""
    agent = AIAgent(
        model=parent.model,
        max_iterations=max_iterations,
    )

    # Shared: MemoryStore is the same Python object
    # Memories written by the review agent are immediately visible
    # to the main agent (on next conversation)
    agent._memory_store = parent._memory_store

    # Isolated: nudge_interval set to 0
    # Prevents the review agent from triggering its own review -> infinite recursion
    agent._memory_nudge_interval = 0
    agent._skill_nudge_interval = 0

    return agent
Tại sao việc chia sẻ MemoryStore lại quan trọng: Khi nhân viên đánh giá gọi memory_tool để ghi, nó hoạt động trên cùng một đối tượng MemoryStore như agent chính. Các thao tác ghi được lưu trực tiếp vào MEMORY.md. Lần tiếp theo nhân viên chính bắt đầu cuộc trò chuyện mới, build_system_prompt() đọc lại MEMORY.md và những ký ức mới sẽ tự động xuất hiện trong lời nhắc hệ thống.
Hướng dẫn: Đánh giá cơ bản hoàn chỉnh
=== Turns 1-10: User and agent discuss a Python project ===

Turn 3: User: "I don't like type hints, and don't use f-strings either"
  -> _turns_since_memory = 3
  -> Agent is busy analyzing code, doesn't call memory_tool

Turn 7: Agent calls terminal, read_file, write_file
  -> _iters_since_skill = 7 (three tool calls)

Turn 10: Conversation ends
  -> _turns_since_memory = 10 -> Triggered!
  -> _iters_since_skill = 7 -> Not triggered (hasn't reached 10)

=== Background review starts (memory review only) ===

1. Main agent returns final reply to user
   (User already sees the reply, unaffected by review)

2. _spawn_background_review(
       messages_snapshot = [complete history of Turns 1-10],
       review_memory = True,
       review_skills = False,
   )

3. Daemon thread starts, creates review_agent:
     model = same as main agent
     max_iterations = 8 (won't run too long)
     _memory_nudge_interval = 0 (prevents cascading)

4. review_agent receives:
     history = complete history of Turns 1-10
     prompt = "Review the conversation... Has the user revealed
               things about themselves...?"

5. review_agent analyzes and finds the user preference at Turn 3
   -> Calls memory_tool:
     save(category="user", content="Dislikes type hints and f-strings")

6. MEMORY.md is updated

7. review_agent says "Saved user preference." then exits
   (This output goes to /dev/null, invisible to the user)

8. Daemon thread ends

=== Next new conversation ===

build_system_prompt() reads MEMORY.md
  -> system prompt now includes:
    "User Profile: Dislikes type hints and f-strings"
  -> Agent won't use type hints when writing code this time
Kịch bản thứ hai: Tại sao cần bảo vệ theo tầng
Điều gì sẽ xảy ra nếu người đại diện đánh giá _memory_nudge_interval không được đặt thành 0?
Main agent completes -> triggers review agent A
Review agent A calls memory_tool -> _turns_since_memory++
  -> A triggers review agent B
    Review agent B calls memory_tool -> triggers review agent C
      -> C triggers D -> D triggers E -> ...
Mỗi agent đánh giá sinh ra một luồng mới với một agent đánh giá mới, lặp lại vô hạn cho đến khi hết bộ nhớ.
Khắc phục: Đặt nudge_interval=0 khi tạo agent đánh giá để nó không bao giờ kích hoạt đánh giá của chính nó.
Một dòng cấu hình sẽ ngăn chặn lỗi sập hệ thống.
Lựa chọn thiết kế độc đáo tại Hermes Agent
Đánh giá không phải là tóm tắt
Hầu hết các khung agent đều coi "sự tự phản ánh" là tạo ra các bản tóm tắt cuộc trò chuyện. agent Hermes không thực hiện tóm tắt -- nó cho phép agent đánh giá vận hành các công cụ trực tiếp.
agent đánh giá có quyền truy cập công cụ giống hệt như agent chính. Nó không "phân tích cuộc trò chuyện và gợi ý đầu ra" -- nó "phân tích cuộc trò chuyện và ghi trực tiếp vào MEMORY.md, trực tiếp tạo các tệp kỹ năng."
Đây là điểm khác biệt quan trọng: các bản tóm tắt là thụ động (con người phải đọc bản tóm tắt và sau đó hành động), trong khi các hoạt động của công cụ là chủ động (agent tự xử lý tất cả).
Thiết kế nỗ lực nhất
Toàn bộ hệ thống xem xét nền có thể bị lỗi mà không ảnh hưởng đến trải nghiệm người dùng:
- Daemon thread: tự động dọn dẹp khi thoát khỏi tiến trình chính
try/except: pass: mọi ngoại lệ đều bị nuốt chửng trong âm thầm- stdout/stderr -> devnull: không có kết quả lạ nào được in ra terminal
- max_iterations=8: sẽ không chạy quá lâu và lãng phí chi phí API
Đây không phải là sự lười biếng - đó là thiết kế có chủ ý. Đánh giá là đóng băng trên bánh, không phải chức năng cốt lõi. Nếu quá trình xem xét không thành công, hậu quả duy nhất là "lần này không học được điều gì" -- nó sẽ thử lại vào lần sau.
Những lỗi thường gặp của người mới bắt đầu
1. Quên bảo vệ tầng
Không cài đặt nudge_interval=0 trên agent xem xét, gây ra đệ quy vô hạn.
Khắc phục: Đặt _memory_nudge_interval = 0 và _skill_nudge_interval = 0 ngay lập tức khi tạo agent đánh giá.
2. Truyền tham chiếu tin nhắn thay vì ảnh chụp nhanh
# Wrong: passing a reference -- main agent's subsequent modifications affect the review
self._spawn_background_review(messages_snapshot=messages)

# Right: passing a snapshot (shallow copy)
self._spawn_background_review(messages_snapshot=list(messages))
agent đánh giá đọc tin nhắn trong một chuỗi nền. Nếu bạn chuyển một tham chiếu và agent chính sửa đổi danh sách thư trong lượt hội thoại tiếp theo, thì agent đánh giá sẽ đọc dữ liệu bị hỏng.
3. Viết lời nhắc đánh giá quá rộng
# Wrong: too broad -- the review agent will try to save every single statement
"Summarize all the key points from this conversation"

# Right: focused -- only save things "worth remembering"
"Has the user revealed things about themselves...
 If nothing is worth saving, just say 'Nothing to save.'"
Lời nhắc xem xét phải bao gồm điều kiện dừng rõ ràng ("Không có gì để lưu"); nếu không, người đánh giá sẽ bịa ra những "khám phá" không tồn tại.
4. Đặt ngân sách lặp lại của agent đánh giá quá cao
Một agent đánh giá có max_iterations=90 có thể dành vài phút và đốt hàng chục nghìn token "suy nghĩ". Đánh giá nên quét nhanh, không phân tích sâu.
Sửa: max_iterations=8 là đủ. Nếu 8 lần lặp lại không đủ để hoàn thành quá trình đánh giá thì lời nhắc cần được thực hiện.
5. Không đặt lại bộ đếm sau các thao tác rõ ràng
Người dùng nói "hãy nhớ rằng tôi không thích gợi ý kiểu", agent gọi bộ nhớ_tool. Nhưng bộ đếm không được đặt lại, vì vậy 10 lượt sau, nhân viên đánh giá sẽ viết lại tùy chọn tương tự.
Khắc phục: Trong quá trình gửi công cụ, hãy kiểm tra xem bộ nhớ hoặc kỹ năng_manage có được gọi hay không. Nếu vậy, hãy đặt lại bộ đếm tương ứng.
Ranh giới giảng dạy
Chương này đề cập đến năm điều:
- Tại sao cần xem xét tự động -- agent quá bận rộn trong công việc nên không thể tự phản ánh
- Bộ đếm kép -- lượt (bộ nhớ) so với lượt lặp (kỹ năng), đặt lại các thao tác rõ ràng
- Cách ly so với chia sẻ -- ảnh chụp nhanh tin nhắn so với MemoryStore dùng chung, so với các subagent s10
- Xem lại thiết kế nhắc nhở -- Tập trung vào "những gì đáng tiết kiệm", phải bao gồm điều kiện dừng
- Nỗ lực tốt nhất + bảo vệ theo tầng -- luồng daemon, lỗi im lặng, nudge_interval=0
Không được bảo hiểm:
- Gọi lại cổng để biết kết quả đánh giá (
background_review_callback) -> chi tiết sản xuất - Triển khai khóa tệp -> Nội bộ MemoryStore, được đề cập trong s07
- Điều chỉnh tần suất đánh giá thích ứng -> tối ưu hóa nâng cao
- Chống trùng lặp trên nhiều đánh giá -> tối ưu hóa sản xuất
Chương này liên quan đến chương khác như thế nào
- Hệ thống bộ nhớ của s07 -> nhân viên xét duyệt gọi tương tự
memory_tool - Hệ thống kỹ năng của s08 -> nhân viên đánh giá có thể tạo kỹ năng mới thông qua
skill_manage - subagent của s10 -> độ tương phản: đồng bộ và không đồng bộ, ngân sách chia sẻ và ngân sách độc lập
- Vòng lặp tạo kỹ năng của s21 -> s20 là "khám phá những thứ đáng để tiết kiệm", s21 là "biến chúng thành những kỹ năng chất lượng cao"
s20 là điểm khởi đầu của Giai đoạn 5. Từ đây trở đi, agent Hermes không còn chỉ là một vòng lặp thực thi các công cụ -- nó bắt đầu học hỏi từ kinh nghiệm của chính mình.
Sau chương này, bạn sẽ có thể trả lời
- Tại sao việc xem lại bộ nhớ được kích hoạt bằng số lần lượt, trong khi việc xem lại kỹ năng được kích hoạt bằng số lần lặp lại công cụ?
- Sự khác biệt cơ bản giữa agent review và agent phụ của s10 là gì?
- Tại sao MemoryStore được chia sẻ nhưng tin nhắn lại bị chụp nhanh?
- Việc đặt nudge_interval của agent đánh giá thành 0 sẽ ngăn cản điều gì?
- Nếu việc xem xét lý lịch không thành công, trải nghiệm của người dùng sẽ bị ảnh hưởng như thế nào?
Một dòng: Đánh giá lý lịch là "phản ánh sau cuộc trò chuyện" của nhân viên hỗ trợ -- sau khi cuộc trò chuyện kết thúc, chuỗi nền sẽ chạy một phiên bản nhân viên độc lập để xem lại cuộc trò chuyện và tự động cập nhật ký ức và kỹ năng. MemoryStore được chia sẻ khiến các thay đổi có hiệu lực ngay lập tức; nudge_interval=0 ngăn chặn đệ quy vô hạn.