docs/en/s18-voice-vision.mdXem bản gốc Bản dịch đầy đủ theo đúng cấu trúc tài liệu; code, liên kết và định danh kỹ thuật được giữ nguyên.
s18: Tiếng nói & Tầm nhìn
s00 > s01 > s02 > s03 > s04 > s05 > s06 > s07 > s08 > s09 > s10 > s11 > s12 > s13 > s14 > s15 > s16 > s17 > [ s18 ] > s19 > s20 > s21 > s22 > s23 > s24 > s25 > s26 > s27
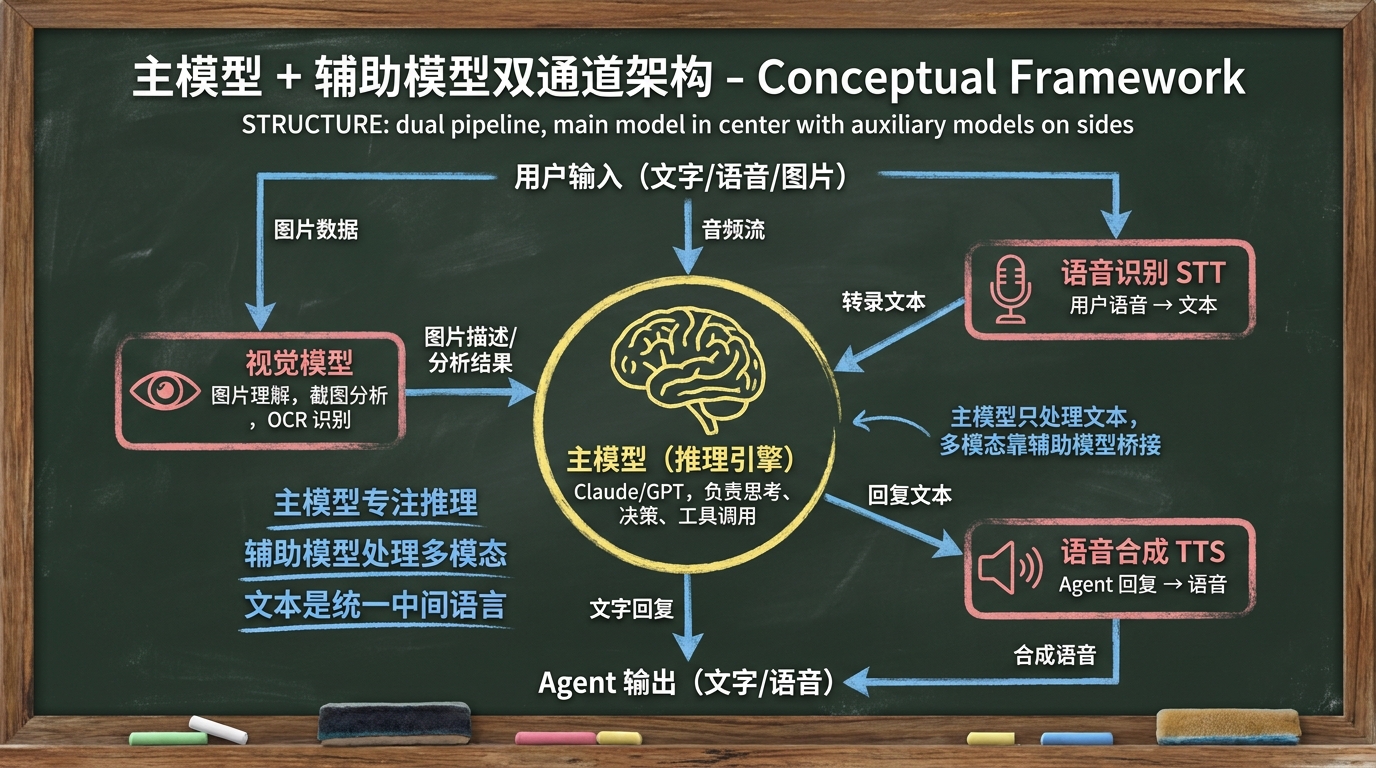
Mô hình chính xử lý suy nghĩ và hội thoại; các mô hình phụ trợ xử lý "nhìn" và "nghe". Họ sử dụng các mô hình khác nhau, thông qua các nhà cung cấp khác nhau và không ảnh hưởng lẫn nhau.
Chương này giải quyết vấn đề gì
Thông qua s17, agent có thể "xem" các trang web thông qua cây khả năng truy cập. Nhưng nếu người dùng gửi ảnh trên WeChat hỏi "Đây là gì?" hoặc gửi tin nhắn thoại -- nhân viên không thể làm gì cả.
Ba kịch bản cụ thể:
Xem hình ảnh. Người dùng gửi ảnh chụp màn hình hỏi "Lỗi này có nghĩa là gì?" agent cần hiểu nội dung hình ảnh.
Nghe giọng nói. Người dùng gửi tin nhắn thoại trên Telegram. agent nhận được một .ogg tập tin âm thanh và cần chuyển nó thành văn bản trước khi nó có thể xử lý bất cứ điều gì.
Đang nói. Câu trả lời của nhân viên hỗ trợ là văn bản nhưng người dùng muốn nghe câu trả lời bằng giọng nói trên Telegram -- giống như trò chuyện với người thật.
Ba điều này có chung một đặc điểm: mô hình chính không cần và không nên xử lý chúng trực tiếp.
Đề xuất đọc
s17-browser-automation.md--browser_visiondựa vào mô hình tầm nhìn của chương nàys13-platform-adapters.md-- tin nhắn thoại được chuyển thành văn bản trong bộ chuyển đổi
Thuật ngữ chính
Mô hình phụ trợ là gì
Hermes Agent sử dụng hai bộ mẫu:
- Mô hình chính: Chạy theo từng lượt hội thoại; phải nhanh và rẻ (ví dụ: Claude Haiku)
- Mẫu phụ trợ: Chỉ gọi khi cần thiết; có thể chậm hơn nhưng phải chuyên dụng (ví dụ: Gemini Flash cho tầm nhìn)
Tại sao không sử dụng mô hình chính cho tầm nhìn?
- Mô hình chính có thể không hỗ trợ đầu vào đa phương thức (mô hình văn bản giá rẻ thiếu khả năng hiển thị)
- Thỉnh thoảng chỉ cần phân tích tầm nhìn -- không đáng sử dụng mô hình đa phương thức đắt tiền cho mỗi lượt
- Lỗi mô hình tầm nhìn sẽ không làm gián đoạn cuộc trò chuyện (nếu mô hình phụ bị hỏng, cuộc đối thoại chính vẫn tiếp tục)
Thẻ MEDIA là gì
Khi một công cụ agent tạo tệp âm thanh (ví dụ: giọng nói do TTS tạo), nó sẽ ghi điểm đánh dấu vào giá trị trả về của công cụ: MEDIA:/path/to/audio.ogg.
Khi Gateway nhìn thấy điểm đánh dấu này, thay vì gửi nó dưới dạng văn bản cho người dùng, nó sẽ gọi địa chỉ của bộ điều hợp send_voice() để gửi tệp âm thanh dưới dạng tin nhắn thoại.
Thẻ MEDIA tách các công cụ khỏi Cổng: các công cụ không cần biết thông báo sẽ chuyển đến nền tảng nào và Cổng không cần biết âm thanh được tạo ra như thế nào.
Bắt đầu với việc thực hiện đơn giản nhất
Yêu cầu model chính nhìn trực tiếp vào hình ảnh:
def handle_vision(args, **kwargs):
    image_url = args["image_url"]
    question = args["question"]

    # Use the primary model's multimodal capabilities directly
    response = client.chat.completions.create(
        model=MODEL,  # Primary model
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": question},
                {"type": "image_url", "image_url": {"url": image_url}},
            ],
        }],
    )
    return response.choices[0].message.content
Ba vấn đề:
Vấn đề 1: Mô hình chính có thể thiếu khả năng quan sát
Nếu MODEL là Claude Haiku hoặc một mô hình chỉ có văn bản khác, mã này sẽ báo lỗi. Bạn không thể cho rằng mô hình chính hỗ trợ đầu vào đa phương thức.
Vấn đề 2: Phân tích tầm nhìn tốn kém
Xử lý hình ảnh bằng mô hình đa phương thức tốn kém hơn nhiều so với xử lý văn bản. Nếu bạn chuyển sang mô hình đa phương thức chỉ dành cho hình ảnh không thường xuyên, mỗi lượt trò chuyện sẽ trở nên đắt đỏ hơn.
Vấn đề 3: URL hình ảnh bên ngoài không đáng tin cậy
Người dùng cung cấp URL hình ảnh mà bạn chuyển trực tiếp tới API mô hình. Tuy nhiên, URL có thể đã hết hạn (các liên kết tạm thời của WeChat Work chỉ tồn tại trong 1 giờ) hoặc có thể trỏ đến một địa chỉ mạng nội bộ (rủi ro SSRF). Bạn cần tải xuống cục bộ, xác thực và chuyển đổi sang base64 trước khi gửi đến mô hình.
Giải pháp: Sử dụng mô hình phụ trợ độc lập cho tầm nhìn, tách biệt hoàn toàn với mô hình chính.
Mô hình tinh thần tối thiểu
+---------------------------------------------+
| Three multimedia capabilities                |
|                                              |
|  Vision (seeing images)                      |
|    Image -> download -> base64 -> auxiliary   |
|    vision model -> text description           |
|                                              |
|  Speech-to-Text STT (hearing voice)          |
|    Audio file -> Whisper / Groq -> text       |
|                                              |
|  Text-to-Speech TTS (speaking)               |
|    Text -> Edge TTS / OpenAI -> audio file    |
|    -> MEDIA:/path -> Gateway -> platform      |
|    voice message                              |
+---------------------------------------------+
Ba khả năng này độc lập: tầm nhìn sử dụng mô hình tầm nhìn phụ trợ, STT sử dụng Whisper và TTS sử dụng dịch vụ tổng hợp giọng nói. Không ai trong số họ phụ thuộc vào mô hình chính.
Tầm nhìn: hình ảnh -> mô tả văn bản
Làm thế nào mô hình biết gọi Vision_analyze
Không có cơ chế đặc biệt nào - nó giống như quy trình khi mô hình quyết định gọi terminal hoặc read_file.
Khi người dùng gửi hình ảnh trên một nền tảng, bộ điều hợp sẽ thực hiện hai việc: tải hình ảnh xuống cục bộ, sau đó đưa đường dẫn hình ảnh vào văn bản tin nhắn của người dùng. Thông báo mà mô hình nhận được trông gần giống như:
The tool list in the system prompt includes:
  vision_analyze: "Analyze an image. Parameters: image_url (path or URL), question"

User message:
  "What does this error mean?
   [Image: /home/user/.hermes/cache/images/abc123.jpg]"
Mô hình nhìn thấy đường dẫn hình ảnh trong tin nhắn + Vision_analyze trong danh sách công cụ -> nó quyết định tự gọi nó. Đây là quá trình suy luận tương tự như khi thấy người dùng nói "liệt kê các tập tin của tôi" và quyết định gọi terminal("ls").
Dòng chảy đầy đủ
1. A user sends an image on WeChat + "What does this error mean?"

2. Adapter: downloads the image -> caches to ~/.hermes/cache/images/abc123.jpg
   -> constructs MessageEvent(text="What does this error mean?", media_urls=["/.../abc123.jpg"])

3. When passed to the agent, the image path is appended to the user message:
   "What does this error mean?\n[Image: /.../abc123.jpg]"

4. Model reasoning: image path present + vision_analyze tool available -> call it
   -> tool_call: vision_analyze(image_url="/.../abc123.jpg", question="What does this error mean?")

5. vision_analyze handler executes:
   -> Reads the image -> converts to base64
   -> Sends to the auxiliary vision model (not the primary model)
   -> Auxiliary model returns: "This is a Python TypeError: 'NoneType' object is not iterable..."

6. tool_result is returned to the primary model -> the primary model continues the conversation with the description
Tại sao tải xuống cục bộ và chuyển đổi sang base64
Tại sao không chuyển URL trực tiếp tới API mô hình:
- URL hình ảnh WeChat Work hết hạn sau 1 giờ; mô hình có thể không tải xuống kịp thời
- URL có thể trỏ đến mạng nội bộ (SSRF)
- Tải xuống cục bộ cho phép xác thực kích thước (ngăn hình ảnh 50 MB làm nổ tung bộ nhớ)
- Base64 được hỗ trợ bởi tất cả các nhà cung cấp; Hỗ trợ URL khác nhau
Cách chọn mô hình tầm nhìn phụ trợ
Hermes tự động chọn theo mức độ ưu tiên:
1. User configured auxiliary.vision.provider -> use it
2. The primary model's provider supports vision -> use the same provider
3. OpenRouter (default: Gemini Flash)
4. Nous Portal (free vision model)
5. None available -> vision is disabled
Cấu hình rõ ràng trong config.yaml:
auxiliary:
  vision:
    provider: "openrouter"
    model: "google/gemini-2.5-flash"
    timeout: 120  # Local models may be slow
Chuyển giọng nói thành văn bản (STT): âm thanh -> văn bản
Một người dùng gửi tin nhắn thoại trên Telegram. Bộ chuyển đổi nhận được một .ogg tập tin âm thanh.
Dòng chảy đầy đủ
Telegram pushes a voice message
    |
    v
TelegramAdapter
    |  Downloads audio -> caches to ~/.hermes/cache/audio/voice_xxx.ogg
    |  Calls transcribe_audio("voice_xxx.ogg")
    |
    v
STT provider (selected by configuration)
    |
    +-- Local Whisper (free, first load takes ~30 seconds)
    +-- Groq (free tier, <5 seconds)
    +-- OpenAI (paid, <10 seconds)
    +-- Mistral (paid, <10 seconds)
    |
    v
Returns text: "Check tomorrow's weather for me"
    |
    v
The adapter fills the text into MessageEvent.text
    -> The agent receives an ordinary text message, unaware it was originally voice
Thiết kế phím: STT xảy ra trong bộ chuyển đổi; tổng đài viên luôn nhìn thấy văn bản. Tổng đài viên không cần biết tin nhắn ban đầu là giọng nói hay văn bản. Điều này tuân theo nguyên tắc tương tự như "bộ điều hợp chịu trách nhiệm dịch" của s13.
So sánh nhà cung cấp STT
| Nhà cung cấp | Miễn phí? | Tốc độ | Cấu hình |
|---|---|---|---|
| Lời thì thầm địa phương | Có | 5-30 giây | Yêu cầu tải xuống mô hình trong lần sử dụng đầu tiên (~150MB) |
| Groq | Cấp miễn phí có sẵn | <5 seconds | Requires GROQ_API_KEY |
| OpenAI | No | <10 seconds | Requires OPENAI_API_KEY |
| Mistral | No | <10 seconds | Requires MISTRAL_API_KEY |
Auto-selection by default: use local Whisper if available; otherwise try Groq -> OpenAI -> Mistral theo thứ tự.
Chuyển văn bản thành giọng nói (TTS): văn bản -> âm thanh
agent muốn gửi trả lời bằng giọng nói cho người dùng.
Dòng chảy đầy đủ
The agent calls text_to_speech("Clear skies in Beijing today, high of 28 degrees.")
    |
    v
TTS provider (selected by configuration)
    |
    +-- Edge TTS (free, 100+ languages)
    +-- OpenAI TTS (paid, high quality)
    +-- ElevenLabs (paid, most natural)
    +-- Others (Mistral, MiniMax, local NeuTTS)
    |
    v
Generates audio file -> ~/.hermes/cache/audio/tts_xxx.ogg
    |
    v
Tool returns: "MEDIA:~/.hermes/cache/audio/tts_xxx.ogg"
    |
    v
Gateway sees the MEDIA tag
    |  -> calls adapter's send_voice(chat_id, audio_path)
    v
The user receives a voice message bubble on Telegram (not a file attachment)
Tại sao Telegram yêu cầu định dạng Opus
Bong bóng tin nhắn thoại của Telegram chỉ nhận dạng được mã hóa Opus .ogg tập tin. Nếu bạn gửi một .mp3, nó xuất hiện dưới dạng tệp đính kèm chứ không phải bong bóng thoại.
Cách tiếp cận của Hermes: phát hiện xem nền tảng hiện tại có phải là Telegram hay không; nếu vậy, hãy chuyển đổi âm thanh sang Opus:
platform = get_session_env("HERMES_SESSION_PLATFORM")
if platform == "telegram":
    # Convert to Opus: ffmpeg -i input.mp3 -acodec libopus output.ogg
    convert_to_opus(audio_path)
Một số nhà cung cấp TTS (OpenAI, ElevenLabs) vốn hỗ trợ đầu ra Opus và không cần chuyển đổi. Edge TTS xuất ra MP3, yêu cầu chuyển đổi ffmpeg.
So sánh nhà cung cấp TTS
| Nhà cung cấp | Miễn phí? | Chất lượng | Tác phẩm bản địa |
|---|---|---|---|
| TTS cạnh | Có | Tốt | Không (cần ffmpeg) |
| OpenAI | Không | Cao | Có |
| ElevenLabs | Không | Tự nhiên nhất | Có |
| Mistral | Không | Cao | Có |
Mặc định: Edge TTS (miễn phí, không cần khóa API).
Luồng toàn diện từ đầu đến cuối với giọng nói Telegram
Người dùng gửi tin nhắn thoại trên Telegram hỏi về thời tiết; người đại diện trả lời bằng giọng nói.
1. The user records a voice message on Telegram: "Check tomorrow's weather for me"

2. Telegram adapter
   -> Downloads the .ogg file
   -> transcribe_audio() -> Whisper -> "Check tomorrow's weather for me"
   -> MessageEvent(text="Check tomorrow's weather for me")

3. GatewayRunner -> agent core loop
   -> The agent sees a text message, calls web_search for weather
   -> The agent composes a reply, calls text_to_speech("Cloudy in Beijing tomorrow, high of 25 degrees")
   -> TTS generates audio.ogg
   -> The agent returns "MEDIA:~/.hermes/cache/audio/audio.ogg"

4. Gateway sees the MEDIA tag
   -> Calls TelegramAdapter.send_voice(chat_id, audio.ogg)
   -> The user receives a voice message bubble on Telegram
Xuyên suốt, agent chỉ xử lý văn bản -- STT và TTS được thực hiện lần lượt tại các điểm vào và ra, trong suốt đối với vòng lặp lõi.
Cách nó cắm vào vòng lặp chính
Ba khả năng này nằm ở các lớp khác nhau của kiến trúc:
Inbound (adapter layer):
  Voice message -> STT -> text -> MessageEvent
  Image message -> download & cache -> local path -> MessageEvent

Core loop (tool layer):
  vision_analyze tool -> auxiliary vision model -> text description
  text_to_speech tool -> TTS provider -> MEDIA tag

Outbound (Gateway layer):
  MEDIA tag -> send_voice -> platform voice message
STT xảy ra ở lớp bộ điều hợp (agent nhìn thấy văn bản), tầm nhìn xảy ra ở lớp công cụ (agent gọi nó một cách chủ động) và TTS được tạo ở lớp công cụ và được phân phối ở lớp Cổng. Bản thân vòng lõi không xử lý đa phương tiện.
Những lỗi thường gặp của người mới bắt đầu
1. Sử dụng mô hình chính để phân tích thị giác
Mô hình chính là Claude Haiku, không hỗ trợ đầu vào đa phương thức. Vượt qua nó một hình ảnh sẽ gây ra lỗi.
Khắc phục: Định tuyến tầm nhìn qua mô hình phụ, tách biệt hoàn toàn với mô hình chính.
2. Truyền URL hình ảnh trực tiếp đến mô hình tầm nhìn
URL có thể đã hết hạn hoặc trỏ đến mạng nội bộ.
Khắc phục: Tải xuống cục bộ trước, xác thực định dạng và kích thước, chuyển đổi sang base64, sau đó gửi đến mô hình tầm nhìn.
3. Âm thanh TTS hiển thị dưới dạng tệp thay vì bong bóng thoại trên Telegram
Bạn đã gửi một .mp3 tập tin. Bong bóng thoại Telegram chỉ nhận dạng được mã hóa Opus .ogg.
Khắc phục: Phát hiện nền tảng; chuyển đổi sang Opus cho Telegram.
4. Thực hiện STT trong vòng lặp lõi thay vì bộ chuyển đổi
Nếu STT là một công cụ, trước tiên nhân viên cần "biết" nó đã nhận được tin nhắn thoại, sau đó quyết định gọi công cụ STT. Tuy nhiên, các định dạng tin nhắn thoại khác nhau trên mọi nền tảng -- đó chính xác là mục đích của bộ điều hợp.
Khắc phục: STT được thực hiện trong bộ chuyển đổi. MessageEvent chỉ chứa văn bản; nhân viên hỗ trợ không cần biết tin nhắn ban đầu là giọng nói.
Phạm vi của chương này
Chương này đề cập đến kiến trúc của ba khả năng đa phương tiện, không phải chi tiết API của từng nhà cung cấp.
Nó bao gồm ba điều:
- Thiết kế mô hình phụ -- tại sao tầm nhìn và cuộc trò chuyện chính lại sử dụng các mô hình khác nhau
- Luồng dữ liệu cho ba khả năng -- tầm nhìn (hình ảnh -> văn bản), STT (âm thanh -> văn bản), TTS (văn bản -> âm thanh)
- Vị trí của chúng trong kiến trúc -- STT ở lớp bộ điều hợp, tầm nhìn ở lớp công cụ, TTS ở lớp công cụ + lớp Cổng
Không được bảo hiểm:
- Chi tiết gọi API cho từng nhà cung cấp TTS/STT -> xem tài liệu của từng nhà cung cấp
- Chi tiết kỹ thuật mã hóa âm thanh (Opus, MP3, WAV) -> kiến thức mã hóa âm thanh
- Lựa chọn và điều chỉnh mô hình tầm nhìn -> chủ đề đo điểm chuẩn mô hình
- Chế độ giọng nói CLI (push-to-talk) -> cải tiến tương tác đầu cuối
Chương này liên quan đến những chương khác như thế nào
- Bộ điều hợp của s13 xử lý việc tải xuống STT và phương tiện -> chương này xác định luồng và nhà cung cấp STT
- s17
browser_visionsử dụng mô hình thị giác phụ trợ được xác định trong chương này - s12's Gateway xử lý các thẻ MEDIA -> chương này định nghĩa ý nghĩa của các thẻ MEDIA
Sau khi kết thúc chương này, bạn sẽ có thể trả lời
- Tại sao phân tích tầm nhìn sử dụng mô hình phụ trợ thay vì mô hình chính?
- Khi người dùng gửi tin nhắn thoại trên Telegram, agent nhận được gì? Một tập tin âm thanh hoặc văn bản?
- Làm sao mà
MEDIA:/path/to/audio.oggđược công cụ TTS trả về có trở thành tin nhắn thoại Telegram không? - Tại sao Telegram yêu cầu định dạng Opus? Điều gì xảy ra nếu bạn gửi MP3?
- Tại sao công cụ tầm nhìn tải hình ảnh và chuyển đổi sang base64 thay vì truyền URL trực tiếp vào mô hình?
Một câu cần nhớ: Mô hình chính chỉ xử lý văn bản. Việc nhìn hình ảnh sử dụng mô hình thị giác phụ trợ, giọng nói nghe được chuyển thành văn bản trong bộ chuyển đổi và việc nói sử dụng các công cụ TTS để tạo ra âm thanh.