docs/en/s27-optimization-and-deploy.mdXem bản gốc Bản dịch đầy đủ theo đúng cấu trúc tài liệu; code, liên kết và định danh kỹ thuật được giữ nguyên.
s27: Tối ưu hóa & Triển khai
s00 > s01 > s02 > s03 > s04 > s05 > s06 > s07 > s08 > s09 > s10 > s11 > s12 > s13 > s14 > s15 > s16 > s17 > s18 > s19 > s20 > s21 > s22 > s23 > s24 > s25 > s26 > [ s27 ]
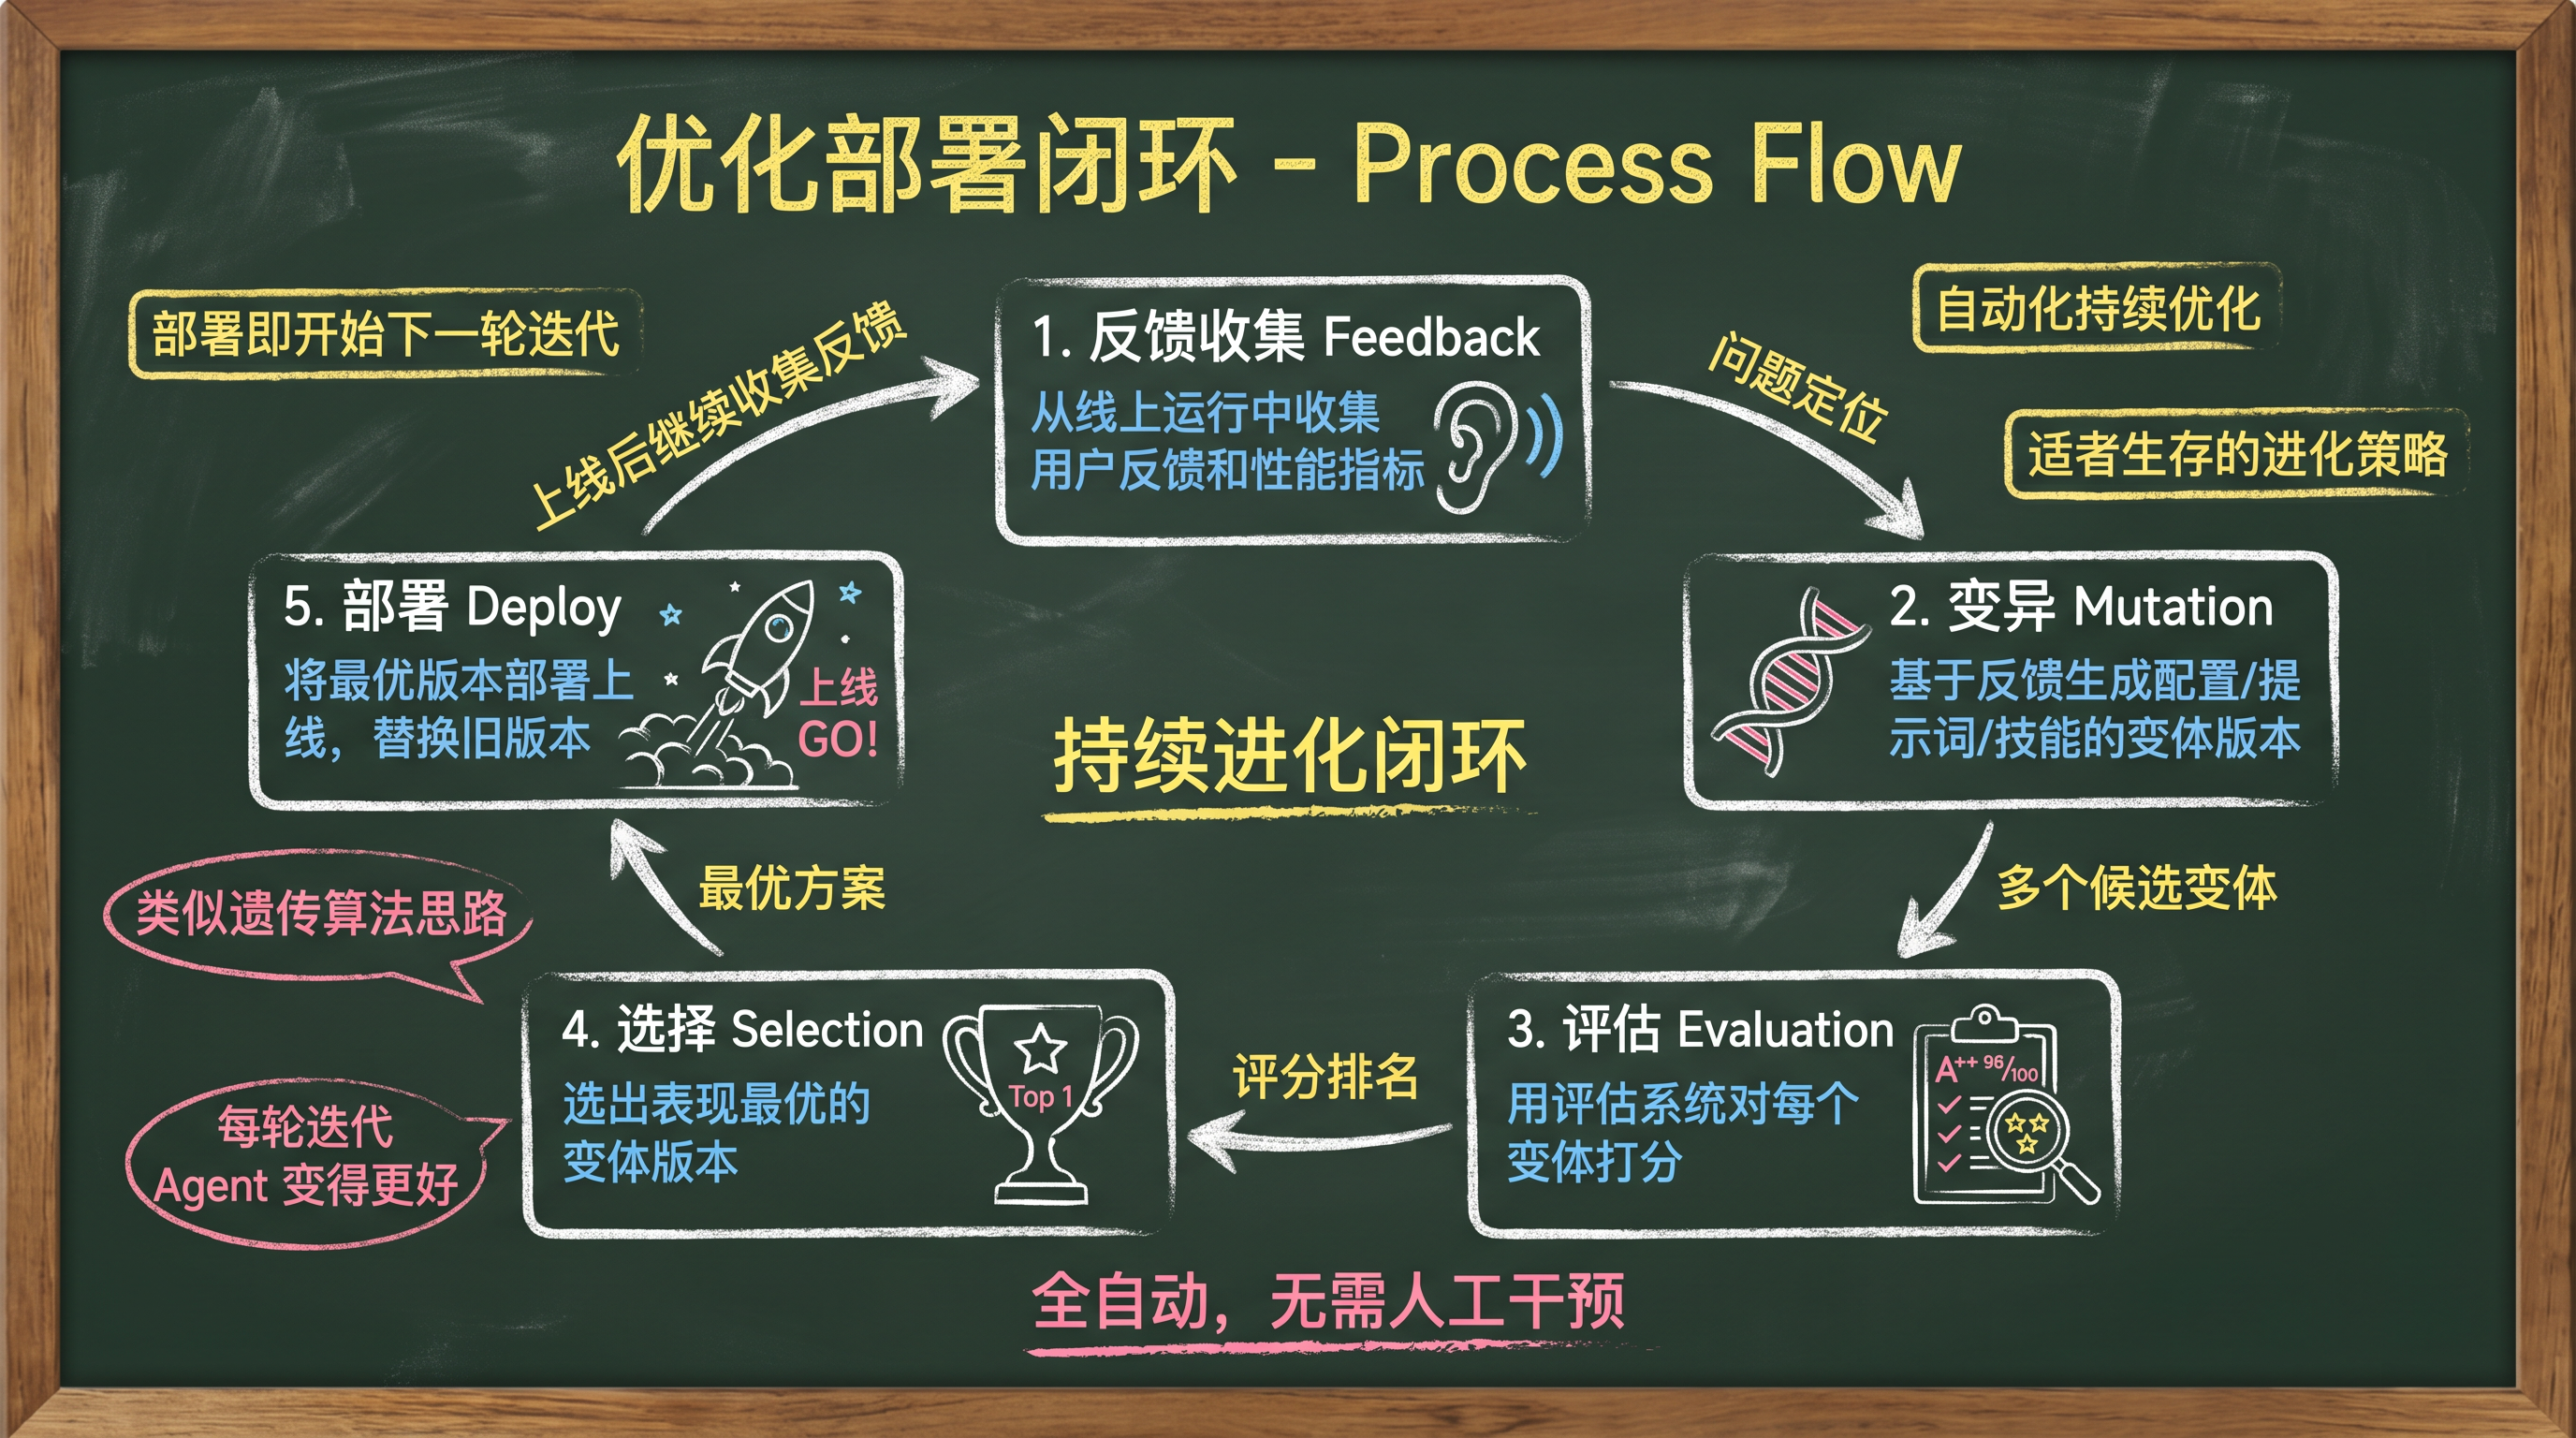
s26 dạy cách định lượng "tốt hay xấu". Chương này tập hợp khả năng đo lường đó thành một vòng tối ưu hóa tự động: thu thập phản hồi, thay đổi, đánh giá, chọn lọc, triển khai. Một quy trình hoàn chỉnh, từ nhập tên kỹ năng đến xuất ra phiên bản tốt hơn.
Chương này giải quyết vấn đề gì
s26 cung cấp cho bạn ba công cụ: SyntheticDatasetBuilder (tạo dữ liệu thử nghiệm), đánh giá_skill (điểm) và ConstraintValidator (cổng).
Nhưng ba công cụ này bị ngắt kết nối. Bạn phải kết nối chúng theo cách thủ công: tạo dữ liệu -> chạy đánh giá -> kiểm tra điểm -> chỉnh sửa kỹ năng theo cách thủ công -> chạy lại đánh giá -> kiểm tra các ràng buộc -> ...
Chương này tự động hóa quy trình thủ công đó -- một lệnh, nhập tên kỹ năng, xuất ra phiên bản tốt hơn.
Đề xuất đọc
s25-skill-evolution.md-- Tổng quan về tiến hóa kỹ năng, quy trình 7 bướcs26-evaluation-system.md-- Bộ ba đánh giá (được sử dụng trong chương này)
Vòng lặp tối ưu hóa: Thu thập phản hồi -> Viết lại có mục tiêu -> Điểm -> Chọn kết quả tốt nhất
Đây là trung tâm của toàn bộ quy trình phát triển kỹ năng -- bước 5 trong sơ đồ quy trình từ s25.
                 +------------------+
                 |  current skill   |
                 +--------+---------+
                          |
                 +--------v---------+
          +------| evaluate on      |
          |      | train set,       |
          |      | collect feedback |
          |      +--------+---------+
          |               |
          |      +--------v---------+
          |      | LLM rewrites     |
          |      | skill based on   |
          |      | feedback         |
          |      +--------+---------+
          |               |
          |      +--------v---------+
          |      | evaluate on      |
     repeat N    | val set --       |
     rounds      | new score higher?|
          |      +----+--------+----+
          |           |        |
          |          yes       no
          |           |        |
          |      keep new   revert to current
          |           |        |
          +----------+         |
                               |
                 +-------------v---+
                 |  best version   |
                 |  exits loop     |
                 +-----------------+
Tại sao nên sử dụng Đột biến theo hướng phản hồi thay vì Đột biến ngẫu nhiên
Đột biến ngẫu nhiên: giao văn bản kỹ năng cho LLM và nói "thay đổi nó" -- LLM không biết phải thay đổi điều gì, thêm hoặc xóa nội dung một cách ngẫu nhiên và rất có thể khiến mọi thứ trở nên tồi tệ hơn.
Đột biến dựa trên phản hồi: đánh giá lần chạy đầu tiên để nhận phản hồi cụ thể ("thiếu các bước xử lý lỗi", "bước 3 không rõ ràng"), sau đó yêu cầu sửa đổi LLM dựa trên phản hồi đó -- nó có định hướng và tỷ lệ trúng cao hơn nhiều.
Đây là điểm khác biệt của GEPA với các thuật toán di truyền truyền thống. GA truyền thống dựa vào đột biến ngẫu nhiên cộng với áp lực chọn lọc để hội tụ từ từ; GEPA đọc dấu vết thực thi để hiểu nguyên nhân và thực hiện các sửa đổi có mục tiêu. Phiên bản giảng dạy mô phỏng ý tưởng tương tự bằng cách sử dụng trường phản hồi.
Lời nhắc đột biến
_MUTATE_PROMPT = (
    "You are optimizing an AI agent skill file...\n\n"
    "CURRENT SKILL TEXT:\n{current_text}\n\n"
    "PERFORMANCE FEEDBACK from evaluation:\n{feedback}\n\n"
    "Based on this feedback, rewrite the skill text to address the issues.\n"
    "Keep the same general purpose and structure, but improve:\n"
    "- Clarity of instructions\n"
    "- Handling of edge cases mentioned in feedback\n"
    "- Step-by-step procedure\n\n"
    "Return ONLY the improved skill text, no explanations."
)
Một số chi tiết thiết kế đáng chú ý:
- "Giữ nguyên mục đích và cấu trúc chung" -- không đại tu; chỉ thực hiện các cải tiến có mục tiêu
- "CHỈ trả lại văn bản kỹ năng đã cải thiện" -- không có giải thích, chỉ là phiên bản mới
- Phản hồi bị cắt ngắn còn 2000 ký tự -- ngăn lời nhắc quá dài
Quy trình hoàn chỉnh: tiến hóa_skill()
Quy trình 7 bước từ s25, hiện ở dạng mã thực thi:
def evolve_skill(skill_name, iterations=5, use_llm=True):
    # 1. Find and load the skill
    skill_file = SKILLS_DIR / skill_name / "SKILL.md"
    raw = skill_file.read_text()
    metadata, body = _parse_frontmatter(raw)

    # 2. Generate eval dataset (s26's SyntheticDatasetBuilder)
    dataset = SyntheticDatasetBuilder().generate(body, num_cases=12)

    # 3. Validate baseline constraints (s26's ConstraintValidator)
    validator = ConstraintValidator()
    validator.validate_all(body)

    # 4. Run the optimizer
    optimizer = SkillOptimizer(use_llm=use_llm)
    result = optimizer.optimize(body, dataset, iterations=iterations)

    # 5. Validate evolved constraints
    evolved_checks = validator.validate_all(result.evolved_text, baseline=body)

    # 6. Evaluate on holdout set (the final exam)
    holdout_score = optimizer._score_on_split(result.evolved_text, dataset.holdout)

    # 7. Back up original + write evolved version
    if result.improvement > 0:
        # Back up to backups/SKILL_<timestamp>.md.bak
        # Write the new version
Hướng dẫn: Phát triển kỹ năng từ dòng lệnh
$ python agents/s27_optimization_and_deploy.py --evolve github-actions-python-ci

  [evolve] loaded: github-actions-python-ci (1200 chars)
  [evolve] generating eval dataset...
  [evolve] dataset: 7t/2v/3h

  [evolve] baseline size_limit: OK (1200/15000)
  [evolve] baseline non_empty: OK
  [evolve] baseline skill_structure: OK

  [evolve] running optimizer (5 iterations)...
  [evolve] baseline score: 0.520

  [evolve] iter 1: 0.520 -> 0.610 (+0.090)
  [evolve] iter 2: 0.610 -> 0.610 (no improvement)
  [evolve] iter 3: 0.610 -> 0.680 (+0.070)
  [evolve] iter 4: no change, skipping
  [evolve] iter 5: 0.680 -> 0.680 (no improvement)

  [evolve] evolved size_limit: OK (1450/15000)
  [evolve] evolved growth_limit: +20.8% FAIL
  -> constraint check failed, not deploying
Lỗi ràng buộc là hoàn toàn bình thường -- LLM có xu hướng thêm nội dung. Đây chính xác là lý do tại sao tăng trưởng_limit tồn tại.
Chiến lược triển khai: Phiên bản giảng dạy so với Hermes trong thực tế
| Khía cạnh | Phiên bản giảng dạy | Hermes trong thực tế |
|---|---|---|
| Sao lưu | Sao chép tập tin (backups/SKILL_<ts>.md.bak) | Nhánh Git (evolve/<target>-<ts>) |
| Triển khai | Ghi đè trực tiếp SKILL.md | Tạo PR, hợp nhất sau khi được con người xem xét |
| Khôi phục | Khôi phục thủ công từ bản sao lưu | git revert |
| Phê duyệt | Không có | Đánh giá PR phải vượt qua |
Đơn giản hóa trong phiên bản giảng dạy có ý nghĩa -- mục tiêu là dạy vòng lặp tối ưu hóa chứ không phải quy trình công việc git. Nhưng trong quá trình sản xuất, bạn phải sử dụng PR -- những thay đổi được tạo tự động cần có sự xem xét của con người.
Những gì Hermes thực sự sử dụng: DSPy + GEPA
SkillOptimizer của phiên bản giảng dạy và Evolve_skill.py của Hermes có cấu trúc tương ứng 1-1:
# Teaching version
optimizer = SkillOptimizer(use_llm=False)
result = optimizer.optimize(skill_text, dataset, iterations=5)

# Hermes in practice
optimizer = dspy.GEPA(metric=skill_fitness_metric, max_steps=10)
optimized_module = optimizer.compile(baseline_module, trainset=trainset, valset=valset)
GEPA bổ sung thêm những gì?
- Phân tích phản ánh: vượt xa điểm số để đọc toàn bộ dấu vết thực thi và hiểu nguyên nhân lỗi
- Tối ưu hóa Pareto: đồng thời tối ưu hóa nhiều chiều (tính chính xác và tính đồng nhất) để tìm mặt trước Pareto
- Quản lý dân số: duy trì nhiều phiên bản ứng viên, không chỉ phiên bản hiện tại và phiên bản tốt nhất
Nhưng ý tưởng cốt lõi là như nhau: ghi điểm -> hiểu tại sao nó tệ -> viết lại có mục đích -> giữ lại kết quả tốt nhất.
Giai đoạn 2-4 sử dụng cùng một cơ chế như thế nào
Chương này thực hiện Giai đoạn 1 (tiến hóa kỹ năng). Giai đoạn 2-4 sử dụng cùng một vòng lặp "điểm -> viết lại -> chọn điểm tốt nhất" -- họ chỉ hoán đổi mục tiêu tiến hóa và phương pháp đánh giá.
Giai đoạn 2: Tiến hóa mô tả công cụ
# Conceptual code (planned in Hermes, not implemented in teaching version)
# Evolution target: tool description text
target_text = registry._tools["search_files"].schema["description"]

# Evaluation method: tool selection accuracy
# "Given a task description, does the agent pick the right tool?"
eval_dataset = generate_tool_selection_dataset()  # (task, correct_tool) pairs

# Constraint: each description <= 500 characters
constraints = ConstraintValidator(max_size=500)
Giai đoạn 3: Tiến hóa phần nhắc nhở hệ thống
# Evolution target: a section of the prompt (e.g., "memory usage guidelines")
target_text = MEMORY_GUIDANCE_SECTION

# Evaluation method: behavioral tests
# "Does the agent save a memory when it should?"
eval_dataset = generate_behavioral_test_cases()

# Constraint: section must not exceed 120% of original (prevent prompt cache invalidation)
constraints = ConstraintValidator(max_growth=0.2)
Giai đoạn 4: Tiến hóa mã công cụ
# Evolution target: Python source code (uses Darwinian Evolver, not GEPA)
# Evaluation method: full pytest pass + no benchmark regression
# Strictest constraints: function signatures cannot change, error handling cannot be removed
Cốt lõi vẫn giữ nguyên: ghi điểm -> viết lại -> chọn cái tốt nhất. Chỉ thay đổi "nội dung cần đánh giá" và "mức độ ràng buộc nghiêm ngặt".
Những lỗi thường gặp của người mới bắt đầu
1. Lặp lại nhiều lần luôn tốt hơn
Không nhất thiết phải như vậy. Ba lần lặp lại có thể đã tìm ra phiên bản tốt nhất, với các lần lặp 4-10 không có tác dụng gì. Và mỗi lần lặp lại sẽ tốn các lệnh gọi API.
Khắc phục: Xem đường cong cải tiến. Nếu 2-3 lần lặp liên tiếp không cải thiện, hãy dừng sớm.
2. Sử dụng phiên bản đã phát triển mà không chạy Holdout
Trình tối ưu hóa đã điều chỉnh nhiều lần trên train + val -- điểm số có thể bị sai lệch. Phần giữ lại chứa dữ liệu mà trình tối ưu hóa chưa từng thấy; đó là "kỳ thi" thực sự.
Khắc phục: Luôn thực hiện đánh giá cuối cùng khi chờ xử lý. Nếu điểm loại trừ thấp hơn mức cơ bản thì đừng triển khai.
3. Bỏ qua kiểm tra ràng buộc
"Điểm được cải thiện 0,15, nhưng kích thước vượt quá 20%" -- điểm rất hấp dẫn nhưng sự phình to về kỹ năng sẽ ảnh hưởng đến mọi cuộc trò chuyện sử dụng nó.
Khắc phục: Ràng buộc là cổng cứng. Cho dù điểm số có tốt đến đâu, nếu hạn chế không thành công, đừng triển khai.
Phạm vi của Chương này
Bao phủ:
- Triển khai đầy đủ vòng lặp tối ưu hóa (thu thập phản hồi -> viết lại có mục tiêu -> ghi điểm -> chọn kết quả tốt nhất)
- Quy trình hoàn chỉnh (evolve_skill, 7 bước)
- Khái niệm và sự khác biệt cho Giai đoạn 2-4
- So sánh với thực tế triển khai của Hermes
Không được bảo hiểm:
- Sử dụng API DSPy/GEPA -> khung bên ngoài
- Cơ chế sinh vật git của Darwin Evolver -> Giai đoạn 4 cụ thể
- Tự động kích hoạt (Giai đoạn 5) -> hiện tại tất cả CLI thủ công
- Quy trình tạo PR và đánh giá mã -> quy trình làm việc git, không phải bản thân quá trình tiến hóa
Chương này liên quan đến chương khác như thế nào
- s25 là bản đồ -> chương này thực hiện các bước 5-7
- s26 cung cấp các công cụ đo lường -> chương này sử dụng chúng (SyntheticDatasetBuilder + đánh giá_skill + ConstraintValidator)
- s08
skill_manage-> chương này sử dụng nó cho lần triển khai cuối cùng - s23 thay đổi mô hình + chương này thay đổi văn bản = hai con đường tiến hóa cho agent
Sau chương này, bạn sẽ có thể trả lời
- Bốn bước của vòng lặp tối ưu hóa là gì? Tại sao sử dụng phản hồi thay vì đột biến ngẫu nhiên?
- 7 bước của develop_skill() có tác dụng gì? Những bước nào sử dụng các thành phần từ s26?
- Bạn nên làm gì nếu việc kiểm tra ràng buộc không thành công sau khi tối ưu hóa?
- Phương pháp đánh giá Giai đoạn 2 (mô tả công cụ) khác với Giai đoạn 1 (kỹ năng) như thế nào?
- Phiên bản giảng dạy và GEPA của Hermes có chung ý tưởng cốt lõi không? Chúng khác nhau ở đâu?
Hãy nhớ một câu: thu thập phản hồi -> yêu cầu viết lại LLM có mục đích -> cho điểm -> giữ lại nếu tốt hơn, loại bỏ nếu không. Lặp lại N vòng; triển khai nếu vượt qua các hạn chế.