docs/en/s26-evaluation-system.mdXem bản gốc Bản dịch đầy đủ theo đúng cấu trúc tài liệu; code, liên kết và định danh kỹ thuật được giữ nguyên.
s26: Hệ thống đánh giá
s00 > s01 > s02 > s03 > s04 > s05 > s06 > s07 > s08 > s09 > s10 > s11 > s12 > s13 > s14 > s15 > s16 > s17 > s18 > s19 > s20 > s21 > s22 > s23 > s24 > s25 > [ s26 ] > s27
Trước khi cải thiện bất cứ điều gì, hãy học cách đo lường nó. Chương này xây dựng cơ sở hạ tầng đánh giá: cách tạo dữ liệu thử nghiệm, cách chấm điểm đầu ra của agent và cách sử dụng các ràng buộc cứng để chặn các thay đổi xấu.
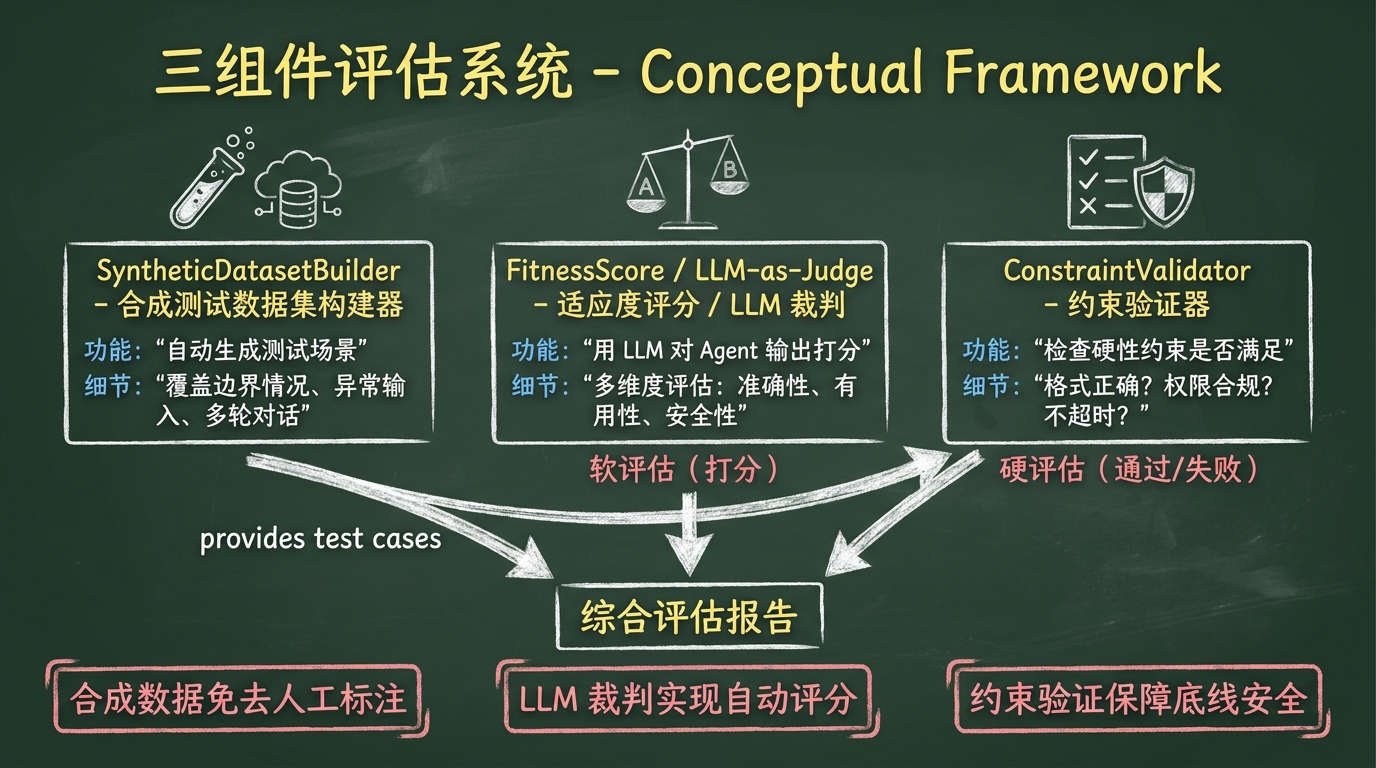
Chương này giải quyết vấn đề gì
s25 đã đưa ra bức tranh đầy đủ về quá trình phát triển kỹ năng và lộ trình của nó. Nhưng quy trình này có một điều kiện tiên quyết: bạn cần một cách để định lượng "tốt hay xấu".
Sau khi chỉnh sửa thủ công SKILL.md, làm sao bạn biết nó tốt hơn hay tệ hơn? Bằng trực giác? Bằng cách chạy một hoặc hai ví dụ?
Những gì quá trình phát triển kỹ năng đòi hỏi là đánh giá có thể lặp lại, định lượng, tự động hóa -- chạy cùng một kỹ năng với cùng một bộ trường hợp thử nghiệm và nhận được điểm. Chỉnh sửa nó, chạy lại, so sánh điểm số. Đó là hệ thống đánh giá.
Ba thành phần:
- Đánh giá tập dữ liệu -- Cần kiểm tra cái gì? (Tổng hợpDatasetBuilder)
- Chức năng thể dục -- Làm thế nào để ghi điểm? (FitnessScore + LLM-với tư cách là giám khảo)
- Ràng buộc kiểm soát -- Khi nào nên từ chối hoàn toàn? (ConstraintValidator)
Đề xuất đọc
s25-skill-evolution.md-- Tổng quan về tiến hóa kỹ năng; chương này bao gồm các bước 2-4 của quy trìnhs08-skill-system.md-- Định dạng tệp kỹ năng (đối tượng đang được đánh giá)
Các quyết định thiết kế chính
Tại sao dự kiến_behavior là một phiếu tự đánh giá, không phải văn bản chính xác
# Bad: exact matching
expected_behavior = "pip install -e '.[dev]'"

# Good: rubric description
expected_behavior = "Should use editable install instead of requirements.txt"
Văn bản chính xác quá dễ vỡ -- "hãy sử dụng pip install -e .[dev]" và "chạy cài đặt có thể chỉnh sửa qua pip" có nghĩa giống nhau, nhưng việc khớp chính xác sẽ đánh dấu cài đặt đó là lỗi. Phiếu tự đánh giá cho phép LLM với tư cách là thẩm phán thực hiện việc hiểu ngữ nghĩa, gần giống với đánh giá của con người hơn nhiều.
Tại sao chia thành train/val/holdout
| Bộ dữ liệu | Được sử dụng bởi | Mục đích |
|---|---|---|
| tàu | Trình tối ưu hóa nhìn thấy nó mọi vòng | Thu thập ý kiến phản hồi, hướng dẫn đột biến |
| giá | Optimizer chọn phiên bản tốt nhất | Ngăn chặn việc trang bị quá mức để tập luyện |
| chờ giữ | Chỉ được sử dụng trong quá trình đánh giá cuối cùng | "Bài kiểm tra" thực sự -- không bao giờ được sử dụng trong quá trình tối ưu hóa |
Nếu bạn chỉ sử dụng một tập dữ liệu, trình tối ưu hóa sẽ "ghi nhớ các câu trả lời" -- nó tiếp tục điều chỉnh để vượt qua các trường hợp kiểm thử cụ thể đó nhưng lại không thực hiện được các tác vụ mới. Sự phân chia ba chiều ngăn chặn kiểu trang bị quá mức này.
Tại sao phản hồi lại quan trọng hơn điểm số
@dataclass
class FitnessScore:
    correctness: float = 0.0
    procedure_following: float = 0.0
    conciseness: float = 0.0
    feedback: str = ""          # <- this field drives the entire optimization
Điểm cho bạn biết "tốt hay xấu." Phản hồi cho bạn biết "tại sao nó xấu và cách khắc phục."
Trong s27, trình tối ưu hóa thu thập phản hồi mỗi vòng và cung cấp phản hồi đó cho LLM để tạo đột biến mục tiêu. Nếu không có phản hồi, đột biến sẽ trở nên mù quáng -- những chỉnh sửa ngẫu nhiên, hy vọng điều tốt nhất. Với phản hồi, đột biến có hướng -- "xử lý lỗi bị thiếu" dẫn đến việc bổ sung xử lý lỗi; "các bước không rõ ràng" dẫn đến việc viết lại cho rõ ràng.
Đây là ý tưởng cốt lõi đằng sau GEPA: đọc dấu vết -> hiểu lý do -> thay đổi có mục đích. Phiên bản giảng dạy mô phỏng ý tưởng tương tự bằng cách sử dụng trường phản hồi.
Thành phần 1: SyntheticDatasetBuilder
Nó làm gì
Đọc văn bản kỹ năng và yêu cầu LLM tạo một tập hợp các trường hợp thử nghiệm. Mỗi trường hợp là một (task_input, expected_behavior) cặp.
Dữ liệu đến từ đâu
Hermes hỗ trợ ba nguồn dữ liệu:
| Nguồn | Thực hiện | Chất lượng | Phiên bản giảng dạy |
|---|---|---|---|
| Tổng hợp | Kỹ năng đọc LLM -> tạo trường hợp | Trung bình | Đã triển khai |
| PhiênDB | Khai thác từ lịch sử hội thoại thực tế + tính điểm LLM | Cao | Chỉ khái niệm |
| Vàng | Bộ bài kiểm tra được viết thủ công | Cao nhất | Chỉ khái niệm |
Hermes' external_importers.py (~500 dòng) cũng có thể khai thác dữ liệu từ lịch sử trò chuyện của chính Claude Code, Copilot và Hermes -- giải quyết vấn đề khởi đầu "người dùng mới không có tập dữ liệu vàng". Nó thực hiện phát hiện bí mật (ngăn khóa API rò rỉ vào tập dữ liệu), lọc mức độ liên quan (LLM đánh giá xem cuộc hội thoại có liên quan đến kỹ năng mục tiêu hay không) và tự động chấm điểm.
Phiên bản giảng dạy chỉ thực hiện tạo tổng hợp -- ý tưởng cốt lõi giống nhau và không cần nguồn dữ liệu bên ngoài.
Thực hiện tối thiểu
class SyntheticDatasetBuilder:
    def generate(self, skill_text: str, num_cases: int = 15) -> EvalDataset:
        prompt = f"Read this skill and generate {num_cases} test cases..."
        response = client.chat.completions.create(model=MODEL, messages=[...])
        # Parse JSON -> create EvalExample list
        # Shuffle -> split 60/20/20 into train/val/holdout
Thành phần 2: đánh giá_skill() + FitnessScore
Nó làm gì
Đưa ra một văn bản về kỹ năng và một trường hợp kiểm tra, hãy trả lời "kỹ năng này thực hiện nhiệm vụ này tốt như thế nào?"
Quy trình hai bước
Step 1: Have the agent process the task using the skill
  system prompt = skill text
  user message = task_input
  -> produces agent_output

Step 2: LLM-as-judge scores the output
  input = skill + task + rubric + agent_output
  -> produces correctness / procedure_following / conciseness / feedback
Nội dung này trình bày chi tiết về hệ thống, giới hạn và cách vận hành của agent.
Chế độ Heuristic nhanh
LLM-as-thẩm phán là chính xác nhưng chậm. Trong quá trình tối ưu hóa, mỗi vòng cần chạy N trường hợp kiểm thử x M lần lặp -- sử dụng LLM cho tất cả chúng là quá tốn kém.
Hermes' skill_fitness_metric() sử dụng trùng lặp từ khóa làm điểm proxy nhanh:
expected_words = set(expected_behavior.lower().split())
skill_words = set(skill_text.lower().split())
overlap = len(expected_words & skill_words) / len(expected_words)
score = 0.3 + 0.7 * overlap
Không chính xác nhưng đủ tốt -- hãy sử dụng nó để tăng tốc vòng lặp tối ưu hóa, sau đó chuyển về LLM với tư cách là người đánh giá để đánh giá cuối cùng.
Thành phần 3: ConstraintValidator
Nó làm gì
Văn bản được phát triển phải vượt qua bốn lần kiểm tra cứng. Nếu bất kỳ lần kiểm tra nào không thành công, thay đổi sẽ bị từ chối -- bất kể điểm số cao đến đâu.
Bốn hạn chế
| Ràng buộc | Quy tắc | Cơ sở lý luận |
|---|---|---|
size_limit | <= 15KB | Prevent skill bloat -- LLMs tend to "add more instructions" to boost scores |
Hệ thống còn có các ràng buộc bổ sung được trình bày trong phiên bản đầy đủ. growth_limit | ||
non_empty | Must not be empty | Mutation can produce empty text |
skill_structure | Must start with # or --- | Ensure valid markdown format |
These four constraints map directly to Hermes' evolution/core/constraints.py.
Hệ thống còn có các ràng buộc bổ sung được trình bày trong phiên bản đầy đủ.
- Full pytest suite must pass (for code evolution)
- Benchmark regression check (TBLite score must not drop more than 2%)
- Semantic fidelity (must not drift from the original purpose)
- Cache compatibility (must not invalidate mid-conversation caches)
Walkthrough: Evaluating a Skill
=== Input ===
skill_text: "# GitHub Actions CI\n1. Create .github/workflows/ci.yml\n2. Use pip install..."
test_case: EvalExample(
    task_input="Help me set up CI for a Python project",
    expected_behavior="Should use pip install -e instead of pip install -r, mention Codecov token"
)

=== Step 1: Agent Execution ===
system: "Follow these instructions:\n# GitHub Actions CI\n1. Create..."
user: "Help me set up CI for a Python project"
-> agent_output: "Sure, I'll help you configure...\n1. Create ci.yml...\nUse pip install -r requirements.txt..."

=== Step 2: LLM-as-judge Scoring ===
input: skill + task + rubric + agent_output
-> {
    "correctness": 0.4,       // used pip install -r, not -e
    "procedure_following": 0.7, // followed most steps
    "conciseness": 0.8,       // response was concise
    "feedback": "Skill does not explicitly say not to use pip install -r; should add a warning at step 2"
  }
-> composite = 0.5*0.4 + 0.3*0.7 + 0.2*0.8 = 0.57

=== Constraint Check ===
size_limit: 800/15000 chars -> OK
non_empty: OK
skill_structure: starts with # -> OK
Hệ thống còn có các ràng buộc bổ sung được trình bày trong phiên bản đầy đủ.
Common Beginner Mistakes
1. Using Exact Matching for Evaluation
Nội dung này mô tả quy tắc đánh giá và cách vận hành trong hệ thống agent. pip install -e
Fix: Use rubric descriptions + LLM-as-judge so that evaluation performs semantic understanding.
2. Running Constraint Gating After Evaluation
Run the full evaluation first (expensive), then discover the evolved skill exceeds 15KB (constraint fails). You just wasted those evaluation API calls.
Fix: Run constraint checks before evaluation. Hermes checks baseline constraints first, then runs optimization, then checks evolved constraints.
3. Eval Dataset Too Small
3 test cases -> the optimizer easily "memorizes the answers" and overfits.
Nội dung này mô tả quy tắc đánh giá và cách vận hành trong hệ thống agent.
Scope of This Chapter
Nội dung này mô tả quy tắc đánh giá và cách vận hành trong hệ thống agent.
Covered:
- How to generate eval datasets (synthetic)
- How the fitness function scores (LLM-as-judge + heuristic)
- How constraint gating rejects bad changes (four hard checks)
Not covered:
- Full implementation of SessionDB mining and external importers -> concept introduced
- DSPy Signature's specific API -> phiên bản giảng dạy sử dụng tính năng hoàn thành trò chuyện trực tiếp
- Benchmark gating (TBLite / YC-Bench) -> yêu cầu môi trường chạy đầy đủ
Chương này liên quan đến chương khác như thế nào
- s25 là tổng quan -> chương này thực hiện các bước 2-4
- s27 là bước 5-7 -> nó tiêu thụ FitnessScore và ConstraintResult được tạo ở đây
- s23
extract_tool_stats()-> có thể đóng vai trò là một nguồn tín hiệu đánh giá (công cụ nào thành công/thất bại)
Sau chương này, bạn sẽ có thể trả lời
- Tại sao dự kiến_behavior sử dụng phiếu tự đánh giá thay vì văn bản chính xác?
- Mỗi phần trong số ba phần tách tập dữ liệu (train/val/holdout) được sử dụng để làm gì? Điều gì xảy ra nếu bạn đánh rơi một cái?
- Ai sử dụng trường phản hồi trong FitnessScore? Tại sao nó quan trọng hơn điểm số?
- Việc hạn chế gating giải quyết được vấn đề gì? Tại sao size_limit là cổng cứng?
- Khi nào bạn sử dụng tính năng tính điểm theo kinh nghiệm nhanh so với LLM với tư cách là giám khảo?
Hãy nhớ một câu: bộ ba đánh giá -- tập dữ liệu cho bạn biết cần kiểm tra những gì, hàm thích hợp cho bạn biết nó tốt đến mức nào và cổng ràng buộc cho bạn biết liệu nó có thể được vận chuyển hay không.