docs/en/s23-trajectory-and-rl.mdXem bản gốc Bản dịch đầy đủ theo đúng cấu trúc tài liệu; code, liên kết và định danh kỹ thuật được giữ nguyên.
s23: Đào tạo quỹ đạo & RL
s00 > s01 > s02 > s03 > s04 > s05 > s06 > s07 > s08 > s09 > s10 > s11 > s12 > s13 > s14 > s15 > s16 > s17 > s18 > s19 > s20 > s21 > s22 > [ s23 ] > s24 > s25 > s26 > s27
s20-s22 cho phép agent học trong runtime -- cập nhật bộ nhớ, tạo kỹ năng, gắn móc. Chương này cho phép agent phát triển ngoại tuyến -- biến quỹ đạo hội thoại thành dữ liệu huấn luyện và sử dụng học tăng cường để huấn luyện thế hệ mô hình tiếp theo.
Chương này giải quyết vấn đề gì
Quá trình xem xét lý lịch từ s20 và tạo kỹ năng từ s21 thể hiện học tập trong runtime -- kiến thức mà tổng đài viên khám phá trong cuộc trò chuyện sẽ được chuyển tới chính họ trong tương lai thông qua các tệp (MEMORY.md, Skills/).
Nhưng điều này có giới hạn: các tập tin lưu trữ "kiến thức" chứ không phải "khả năng". agent có thể biết rằng "người dùng không thích gợi ý loại" (kiến thức), nhưng khả năng viết mã của nó không được cải thiện chỉ vì bộ nhớ đó.
Để tự cải thiện khả năng, bạn cần đào tạo mô hình.
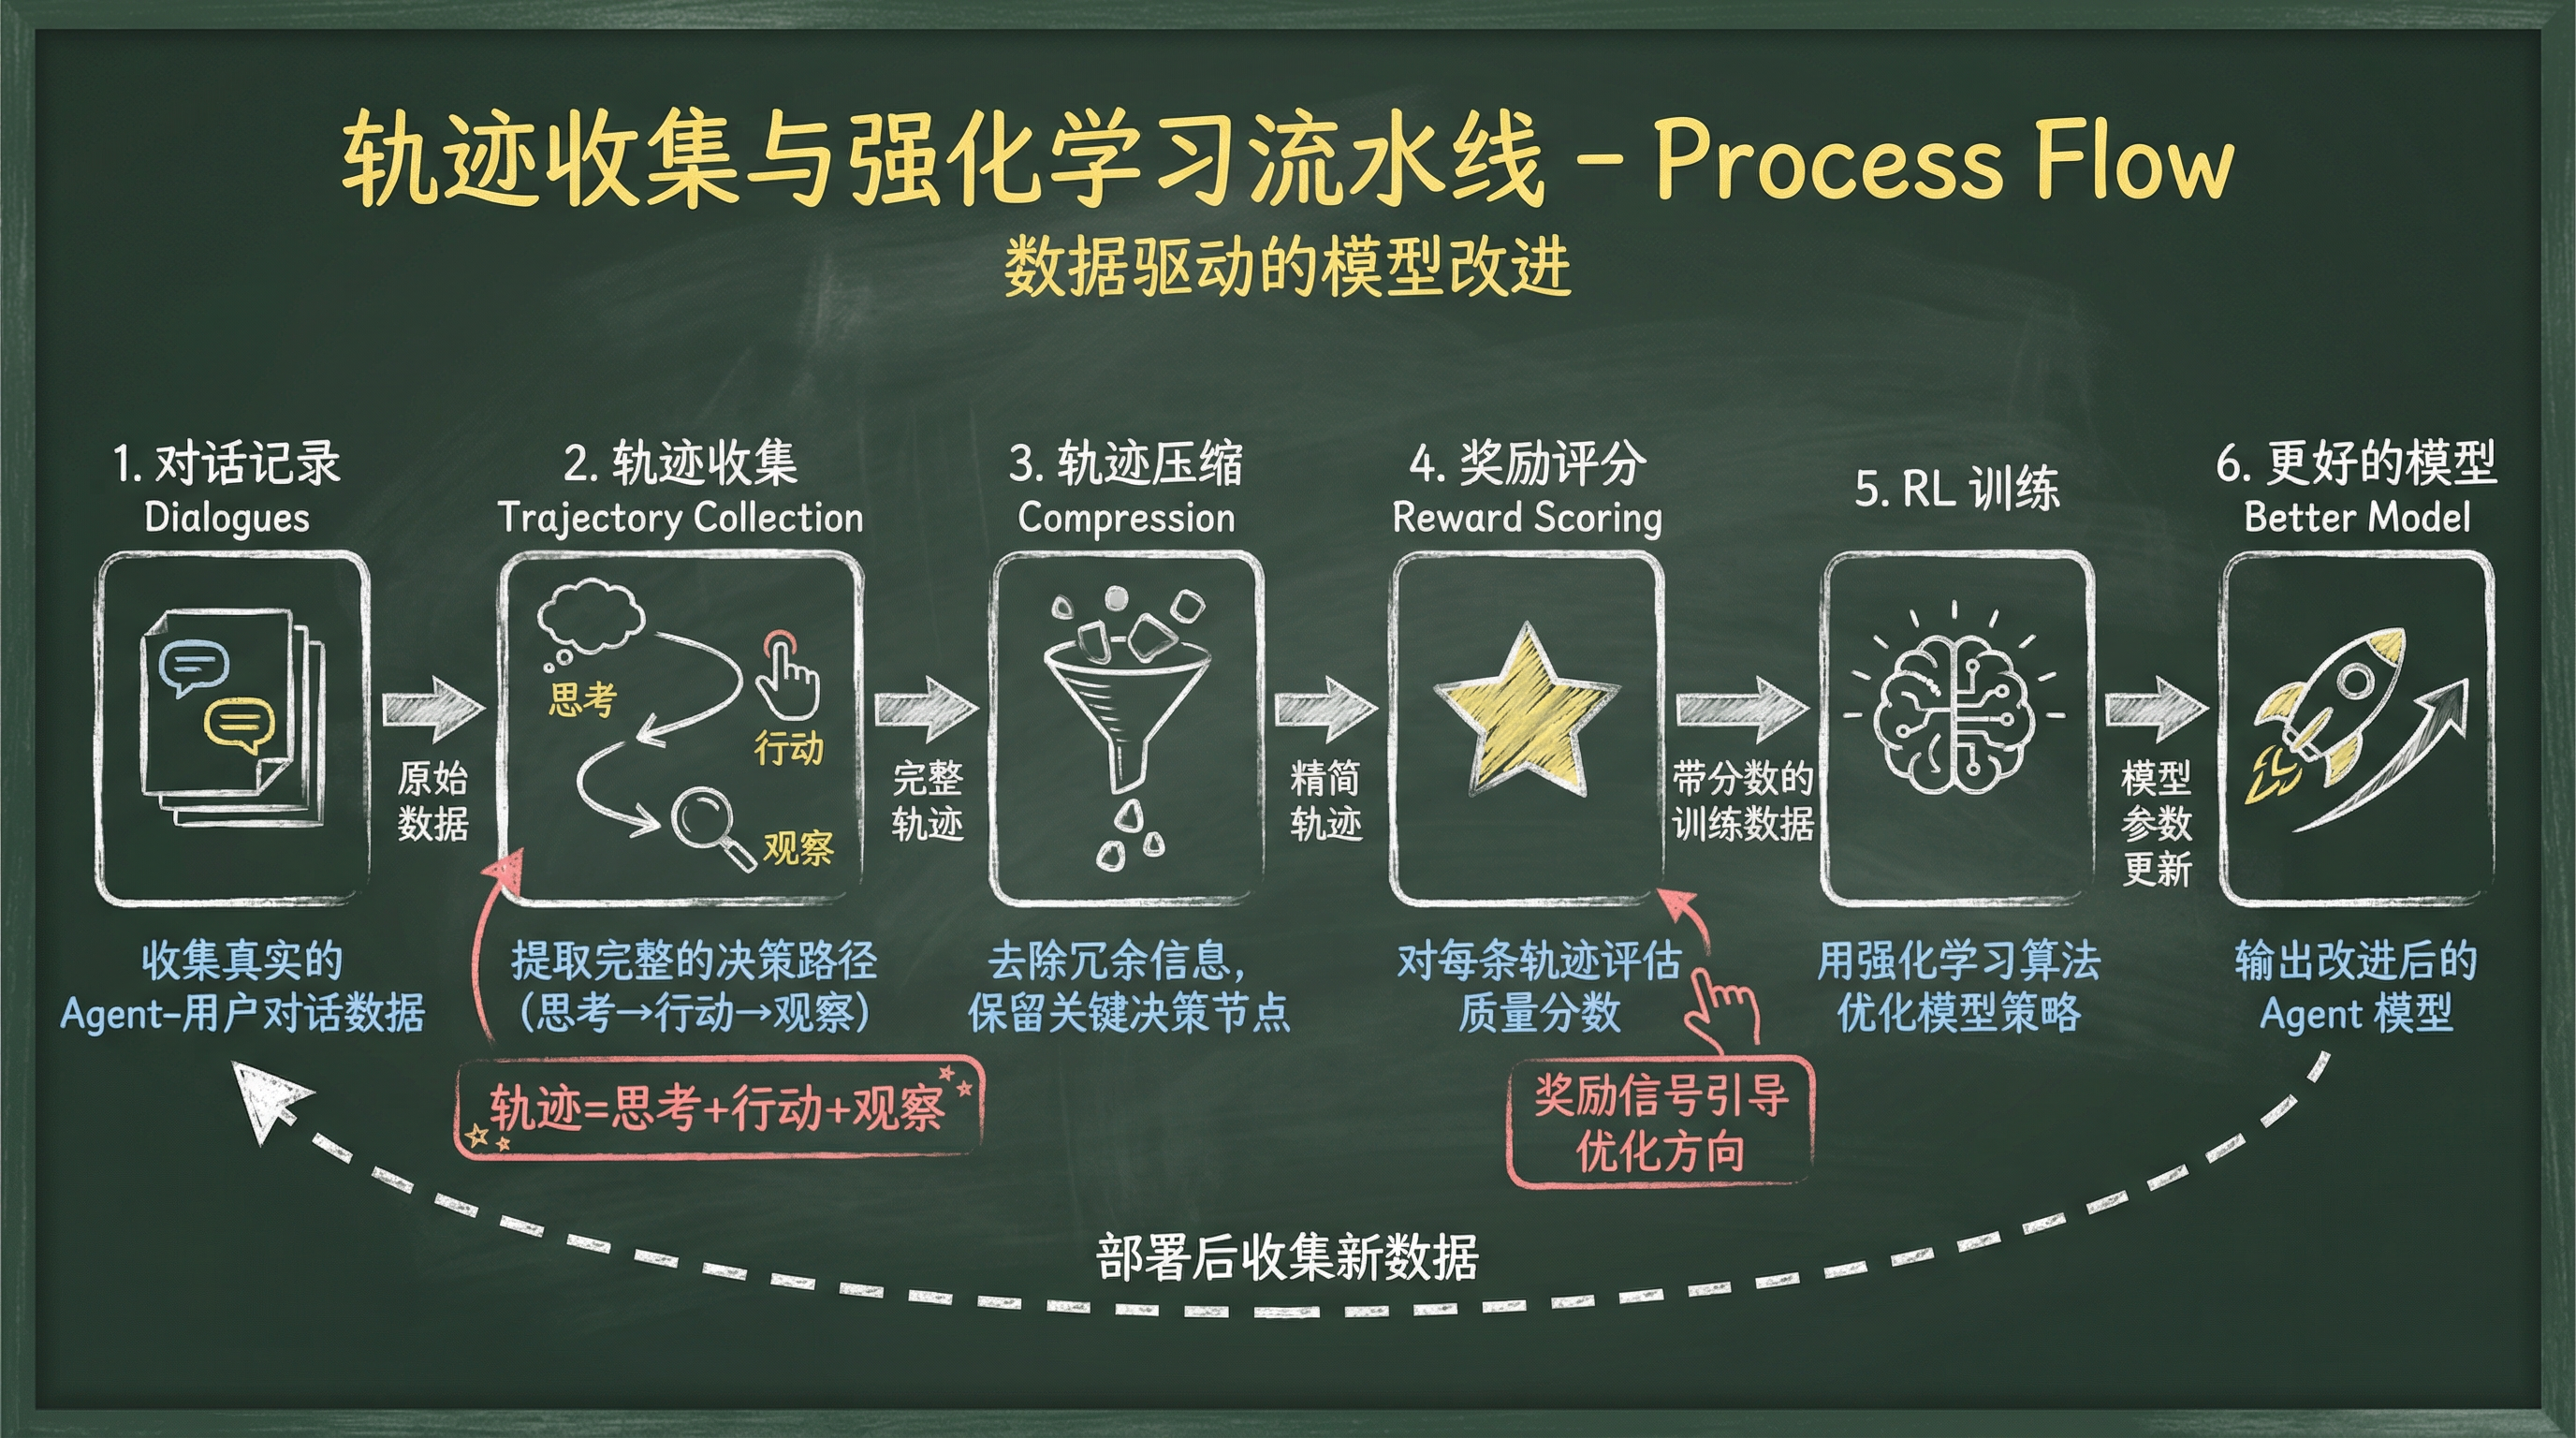
Đường ống đầy đủ:
Conversation -> trajectory collection -> trajectory compression -> reward scoring -> RL training -> better model
Kịch bản: Từ 1.000 cuộc trò chuyện đến mô hình mạnh mẽ hơn.
1. batch_runner runs the agent on 500 prompts, 2 runs per prompt
   -> 1,000 conversation trajectories, stored as JSONL

2. trajectory_compressor compresses long trajectories to under 15K tokens
   -> Preserves key information at head and tail, replaces middle with summaries

3. Environment scoring: each trajectory receives 0-2 points based on task completion
   -> Complete = 2.0, partial = 1.0, failure = 0.0

4. GRPO training: fine-tune the model using reward signals
   -> 2,500 steps, LoRA rank 32, lr 4e-5

5. The new model performs better on the same prompts
Đây không phải là lý thuyết -- mô hình của agent Hermes được lặp lại chính xác theo cách này.
Đề xuất đọc
s01-the-agent-loop.md-- Mỗi quỹ đạo về cơ bản là một bản ghi hoàn chỉnh của một quỹ đạorun_conversationgọis20-background-review.md-- So sánh đào tạo trong runtime và đào tạo ngoại tuyếns05-context-compression.md-- Nén quỹ đạo sử dụng lại ý tưởng từ nén ngữ cảnh
Các khái niệm chính
Quỹ đạo là gì
Bản ghi của một cuộc trò chuyện hoàn chỉnh, được định dạng ở định dạng ShareGPT:
[
  {"from": "system", "value": "You are a helpful assistant..."},
  {"from": "human",  "value": "Write me a Python script"},
  {"from": "gpt",    "value": "<think>Let me analyze the requirements first...</think>Sure, I'll write..."},
  {"from": "gpt",    "value": "<tool_call>{\"name\": \"write_file\", ...}</tool_call>"},
  {"from": "tool",   "value": "<tool_response>{\"content\": \"Written 50 chars\"}</tool_response>"},
  {"from": "gpt",    "value": "The file is ready. You can try running it."}
]
Gần giống với các thông báo phiên trong SQLite, nhưng có hai phép biến đổi chính:
- Lý luận (quá trình suy nghĩ của mô hình) được bao bọc thống nhất trong
<think>thẻ - Các cuộc gọi công cụ được gói gọn trong
<tool_call>/<tool_response>thẻ
batch_runner là gì
Một công cụ để chạy agent với số lượng lớn. Nó nhận một danh sách các lời nhắc (JSONL), khởi chạy một phiên bản agent cho mỗi lời nhắc, đồng thời thu thập quỹ đạo và số liệu thống kê.
Hỗ trợ song song, nối lại điểm kiểm tra và tự động lọc các mẫu chất lượng thấp.
quỹ đạo_compressor là gì
Một máy nén quỹ đạo. Nhiều quỹ đạo hội thoại rất dài (hàng chục nghìn token), khiến việc đào tạo trực tiếp không hiệu quả. Trình nén giữ nguyên nội dung chính ở phần đầu và phần đuôi, thay thế phần giữa bằng bản tóm tắt do LLM tạo và đưa quỹ đạo xuống độ dài mục tiêu (mặc định là 15.250 token).
GRPO là gì
Tối ưu hóa chính sách tương đối của nhóm. Một thuật toán học tăng cường phù hợp hơn với các mô hình ngôn ngữ so với PPO. Ý tưởng cốt lõi: tạo nhiều quỹ đạo cho cùng một lời nhắc, sử dụng tín hiệu khen thưởng để cho mô hình biết "cái nào tốt hơn" và cập nhật mô hình để hướng tới kết quả tốt hơn.
Mô hình tinh thần tối thiểu
Phase 1: Collection
  prompts.jsonl -> batch_runner -> trajectory_samples.jsonl
                                  + tool_stats
                                  + reasoning_stats

Phase 2: Compression
  trajectory_samples.jsonl -> trajectory_compressor -> compressed.jsonl
    (50K tokens)              (preserve head/tail,     (15K tokens)
                               compress middle)

Phase 3: Scoring
  compressed.jsonl -> environment scoring function -> scored.jsonl
    each trajectory + original prompt                (trajectory + reward)

Phase 4: Training
  scored.jsonl -> GRPO trainer -> new model weights
    multiple trajectories per prompt     LoRA adapters
    reinforce high-reward, weaken low-reward
Cấu trúc dữ liệu chính
Bản ghi quỹ đạo (đầu ra batch_runner)
{
  "trajectory": [
    {"from": "system", "value": "..."},
    {"from": "human", "value": "..."},
    {"from": "gpt", "value": "<think>...</think>..."}
  ],
  "tool_stats": {
    "terminal": {"count": 5, "success": 4, "failure": 1},
    "read_file": {"count": 3, "success": 3, "failure": 0}
  },
  "reasoning_stats": {
    "total_assistant_turns": 8,
    "turns_with_reasoning": 6,
    "turns_without_reasoning": 2,
    "has_any_reasoning": true
  },
  "completed": true,
  "api_calls": 12,
  "toolsets_used": ["terminal", "file"]
}
Cấu hình nén
tokenizer_name: "moonshotai/Kimi-K2-Thinking"
target_max_tokens: 15250
summary_target_tokens: 750

# Protection policy: don't compress head or tail
protect_first_system: true
protect_first_human: true
protect_first_gpt: true
protect_last_n_turns: 4

# Summarization model
summarization_model: "google/gemini-3-flash-preview"
summarization_temperature: 0.3
Chức năng khen thưởng
def correctness_reward(prompts, completions, answer):
    """2.0 points if fully correct, 0.0 if wrong."""
    rewards = []
    for completion, expected in zip(completions, answer):
        if expected in completion:
            rewards.append(2.0)
        else:
            rewards.append(0.0)
    return rewards

def format_reward(completions):
    """0.5 points if format is correct (has <think> and <tool_call> tags)."""
    rewards = []
    for c in completions:
        score = 0.0
        if "<think>" in c and "</think>" in c:
            score += 0.25
        if "<tool_call>" in c:
            score += 0.25
        rewards.append(score)
    return rewards
Các hàm phần thưởng có thể kết hợp được -- tính chính xác mang lại điểm cao nhất (2,0), trong khi định dạng đóng vai trò là tín hiệu phụ (0,5). GRPO sử dụng số tiền có trọng số làm phần thưởng cuối cùng.
Thực hiện tối thiểu
Bước 1: Chuyển đổi định dạng quỹ đạo
Chuyển đổi tin nhắn từ run_conversation sang định dạng ShareGPT:
def convert_to_trajectory(messages: list[dict]) -> list[dict]:
    """Convert OpenAI-format messages to ShareGPT trajectory format."""
    trajectory = []
    for msg in messages:
        role = msg.get("role", "")
        content = msg.get("content", "")

        # Role mapping
        if role == "system":
            from_field = "system"
        elif role == "user":
            from_field = "human"
        elif role == "assistant":
            from_field = "gpt"
            # Tool calls: wrap in <tool_call> tags
            if msg.get("tool_calls"):
                for tc in msg["tool_calls"]:
                    fn = tc.get("function", {})
                    tc_text = json.dumps({
                        "name": fn.get("name", ""),
                        "arguments": json.loads(fn.get("arguments", "{}")),
                    }, ensure_ascii=False)
                    content += f"\n<tool_call>\n{tc_text}\n</tool_call>"
        elif role == "tool":
            from_field = "tool"
            # Wrap in <tool_response> tags
            tool_id = msg.get("tool_call_id", "")
            content = (f"<tool_response>\n"
                       f'{{"tool_call_id": "{tool_id}", '
                       f'"content": {json.dumps(content, ensure_ascii=False)}}}\n'
                       f"</tool_response>")
        else:
            continue

        trajectory.append({"from": from_field, "value": content})

    return trajectory
Bước 2: Công cụ trích xuất thống kê
def extract_tool_stats(messages: list[dict]) -> dict:
    """Count tool usage: how many calls, successes, failures per tool."""
    stats: dict[str, dict] = {}
    # Find all tool_call -> tool pairs
    tool_calls = {}
    for msg in messages:
        if msg.get("role") == "assistant" and msg.get("tool_calls"):
            for tc in msg["tool_calls"]:
                fn = tc.get("function", {})
                tool_calls[tc["id"]] = fn.get("name", "unknown")
        elif msg.get("role") == "tool":
            tc_id = msg.get("tool_call_id", "")
            tool_name = tool_calls.get(tc_id, "unknown")
            if tool_name not in stats:
                stats[tool_name] = {"count": 0, "success": 0, "failure": 0}
            stats[tool_name]["count"] += 1
            content = msg.get("content", "")
            if "error" in content.lower()[:100]:
                stats[tool_name]["failure"] += 1
            else:
                stats[tool_name]["success"] += 1
    return stats
Bước 3: Thu thập hàng loạt (batch_runner đơn giản hóa)
def run_batch(prompts: list[str], output_path: str):
    """Run agent on each prompt, collect trajectories."""
    results = []
    for i, prompt in enumerate(prompts):
        conn = init_db(":memory:")
        session_id = create_session(conn)
        cached_prompt = build_system_prompt(os.getcwd())

        try:
            result = run_conversation(prompt, conn, session_id, cached_prompt)
            messages = result["messages"]
            trajectory = convert_to_trajectory(messages)
            tool_stats = extract_tool_stats(messages)

            results.append({
                "prompt_index": i,
                "trajectory": trajectory,
                "tool_stats": tool_stats,
                "completed": result.get("final_response") is not None,
                "api_calls": len([m for m in messages if m.get("role") == "assistant"]),
            })
        except Exception as e:
            results.append({
                "prompt_index": i,
                "trajectory": [],
                "completed": False,
                "error": str(e),
            })
        finally:
            conn.close()

        print(f"  [{i+1}/{len(prompts)}] {'OK' if results[-1].get('completed') else 'FAIL'}")

    # Write to JSONL
    with open(output_path, "w") as f:
        for r in results:
            f.write(json.dumps(r, ensure_ascii=False) + "\n")

    ok = sum(1 for r in results if r.get("completed"))
    print(f"\nBatch complete: {ok}/{len(prompts)} succeeded -> {output_path}")
    return results
Bước 4: Nén quỹ đạo (Đơn giản hóa)
def compress_trajectory(
    trajectory: list[dict],
    target_tokens: int = 15250,
    protect_last_n: int = 4,
) -> tuple[list[dict], dict]:
    """
    Compress a trajectory to fit within target token budget.

    Strategy: protect head (system + first human + first gpt) and
    tail (last N turns). Compress middle into a summary.

    Returns (compressed_trajectory, metrics).
    """
    original_tokens = estimate_tokens_trajectory(trajectory)
    if original_tokens <= target_tokens:
        return trajectory, {
            "was_compressed": False,
            "original_tokens": original_tokens,
            "compressed_tokens": original_tokens,
        }

    # Protect head: system + first human + first gpt/tool
    head = []
    rest = list(trajectory)
    for role in ["system", "human", "gpt"]:
        for i, turn in enumerate(rest):
            if turn["from"] == role:
                head.append(rest.pop(i))
                break

    # Protect tail
    tail = rest[-protect_last_n:] if len(rest) > protect_last_n else []
    middle = rest[:-protect_last_n] if tail else rest

    # Compress middle section into a summary
    if middle:
        summary_text = _summarize_middle(middle)
        compressed_middle = [{"from": "system", "value": f"[Summary of {len(middle)} turns]\n{summary_text}"}]
    else:
        compressed_middle = []

    compressed = head + compressed_middle + tail
    compressed_tokens = estimate_tokens_trajectory(compressed)

    return compressed, {
        "was_compressed": True,
        "original_tokens": original_tokens,
        "compressed_tokens": compressed_tokens,
        "turns_removed": len(middle),
    }


def _summarize_middle(turns: list[dict]) -> str:
    """Generate a concise summary of the middle turns."""
    # Teaching version uses rule-based summary; production version uses LLM
    tools_used = set()
    errors = 0
    for t in turns:
        if "<tool_call>" in t.get("value", ""):
            import re as _re
            names = _re.findall(r'"name":\s*"(\w+)"', t["value"])
            tools_used.update(names)
        if t["from"] == "tool" and "error" in t.get("value", "").lower():
            errors += 1

    parts = [f"Agent executed {len(turns)} turns."]
    if tools_used:
        parts.append(f"Tools used: {', '.join(sorted(tools_used))}.")
    if errors:
        parts.append(f"Encountered {errors} error(s) and recovered.")
    return " ".join(parts)


def estimate_tokens_trajectory(trajectory: list[dict]) -> int:
    """Rough token estimate for a trajectory."""
    total_chars = sum(len(t.get("value", "")) for t in trajectory)
    return total_chars // 4  # rough estimate
Hướng dẫn: Vòng đời đầy đủ của một quỹ đạo
=== Phase 1: Collection ===

prompt: "Write a Python script to convert Markdown to HTML"

Agent executes:
  Turn 1: [gpt] <think>I should use the markdown library...</think> I'll write a script.
  Turn 2: [gpt] <tool_call>{"name": "terminal", "arguments": {"command": "pip install markdown"}}</tool_call>
  Turn 3: [tool] <tool_response>{"content": "Successfully installed markdown-3.6"}</tool_response>
  Turn 4: [gpt] <tool_call>{"name": "write_file", ...}</tool_call>
  Turn 5: [tool] <tool_response>{"content": "Written 120 chars"}</tool_response>
  Turn 6: [gpt] <tool_call>{"name": "terminal", "arguments": {"command": "python convert.py test.md"}}</tool_call>
  Turn 7: [tool] <tool_response>{"content": "<h1>Hello</h1>"}</tool_response>
  Turn 8: [gpt] Script is ready and tests pass.

tool_stats: terminal(2/2), write_file(1/1)
reasoning_stats: 1/4 turns with <think>
completed: true

=== Phase 2: Compression ===

Original: 8 turns, ~3,000 tokens -> no compression needed (< 15,250)
(For a complex conversation with 50K tokens, Turns 3-5 would be compressed into a summary)

=== Phase 3: Scoring ===

correctness_reward: script runs and output is correct -> 2.0
format_reward: has <think> and <tool_call> -> 0.5
total_reward: 2.5

=== Phase 4: Training ===

GRPO receives multiple trajectories for the same prompt (e.g., 4):
  Trajectory A: reward 2.5 (success + good format)
  Trajectory B: reward 2.0 (success but no think)
  Trajectory C: reward 0.5 (failure but correct format)
  Trajectory D: reward 0.0 (failure + bad format)

Model update direction: reinforce behavior patterns from A and B, weaken C and D
Tại sao không chỉ sử dụng SFT (Tinh chỉnh được giám sát)
SFT chỉ học từ "câu trả lời đúng". Nhưng các cuộc trò chuyện của nhân viên hỗ trợ chứa một lượng lớn hành vi khám phá -- thử và sai, quay lại, chuyển đổi phương pháp tiếp cận -- những hành vi không có "câu trả lời đúng", chỉ có mức độ "tốt hay xấu".
Ưu điểm của RL: nó có thể học được sự khác biệt giữa "gần đúng" và "hoàn toàn sai". SFT chỉ có hai trạng thái: "đã học" và "không học được".
| SFT | RL (GRPO) | |
|---|---|---|
| Tín hiệu | Nhị phân: đúng/sai | Liên tục: điểm thưởng |
| Nó học được gì | Bắt chước quỹ đạo chính xác | Học hỏi từ những so sánh tốt/xấu |
| Thái độ đối với việc khám phá | Bỏ qua nó | Khám phá thất bại cũng có giá trị học hỏi |
| Hiệu quả dữ liệu | Yêu cầu câu trả lời đúng chất lượng cao | Mọi quỹ đạo đều có thể sử dụng được (miễn là có phần thưởng) |
Những lỗi thường gặp của người mới bắt đầu
1. Không lọc ra các mẫu không có lý do
Nếu agent tạo ra một quỹ đạo không có <think> lý luận nào cả, quỹ đạo đó dạy cho mô hình "bạn có thể hành động mà không cần suy nghĩ".
Khắc phục: batch_runner tự động loại bỏ các mẫu trong đó has_any_reasoning=false.
2. Nén đầu hoặc đuôi
Phần đầu (lời nhắc hệ thống + câu hỏi của người dùng) xác định nhiệm vụ là gì. Phần đuôi (vài lượt cuối) chứa kết quả cuối cùng. Nén đi một trong hai và mô hình sẽ học được "một quy trình trung gian không có mục tiêu".
Khắc phục: Protect_first_system/human/gpt + Protect_last_n_turns không bao giờ bị nén.
3. Chức năng khen thưởng chỉ kiểm tra tính đúng đắn
Chỉ chấm điểm bằng "kết quả cuối cùng có đúng không." Mô hình học được rằng "đoán đúng mới là quan trọng" -- nó sẽ bỏ qua việc suy luận và chuyển ngay sang việc đoán câu trả lời.
Khắc phục: Xếp chồng định dạng_phần thưởng lên trên, khen thưởng cho định dạng lý luận tốt và trừng phạt các quỹ đạo không có <think>.
4. Chỉ chạy mỗi lời nhắc một lần
GRPO cần so sánh nhiều quỹ đạo cho cùng một dấu nhắc. Chạy một lần không có gì để so sánh.
Khắc phục: Chạy mỗi lời nhắc ít nhất 2 lần (có thể định cấu hình trong batch_runner).
Ranh giới giảng dạy
Chương này bao gồm bốn điều:
- Định dạng quỹ đạo -- Định dạng ShareGPT, thẻ lý do, thẻ tool_call/tool_response
- Bộ sưu tập hàng loạt -- đường dẫn dẫn đến quỹ đạo nhanh chóng của batch_runner
- Nén quỹ đạo -- Bảo vệ đầu và đuôi, nén phần giữa, ngân sách token
- Kiến thức cơ bản về đào tạo RL -- Chức năng khen thưởng, cách tiếp cận GRPO, tại sao chỉ SFT là không đủ
Không được bảo hiểm:
- Đạo hàm toán học của GRPO -> Khóa học lý thuyết RL
- API cụ thể cho Atropos/Tinker -> tích hợp nền tảng
- Cấu hình WandB và giải thích số liệu -> Chi tiết MLOps
- Đào tạo đa GPU và lập kế hoạch phân phối -> cơ sở hạ tầng
- Nguồn dữ liệu cụ thể và làm sạch -> kỹ thuật dữ liệu
Chương này liên quan đến chương khác như thế nào
- Vòng lặp cốt lõi của s01 -> mỗi quỹ đạo là một bản ghi hoàn chỉnh của một quỹ đạo
run_conversationgọi - Nén ngữ cảnh của s05 -> nén quỹ đạo sử dụng lại chiến lược "bảo vệ đầu và đuôi, nén ở giữa" tương tự
- Đánh giá lý lịch của s20 -> tìm hiểu runtime (sửa đổi tệp); s23 đang học offline (sửa đổi mô hình)
- Sáng tạo kỹ năng của s21 -> tiến hóa runtime; s23 là tiến hóa cấp độ di truyền
- Kiến trúc plugin của s24 -> Môi trường RL có thể được mở rộng dưới dạng plugin
s20-s21 thể hiện quá trình "học tập" của agent; s23 tượng trưng cho sự "tiến hóa" của agent Việc học làm thay đổi kiến thức; sự tiến hóa tự thay đổi khả năng.
Sau chương này, bạn sẽ có thể trả lời
- Tại sao lý luận được gói gọn trong
<think>thẻ ở định dạng quỹ đạo? - Tại sao đầu và đuôi không thể nén được trong quá trình nén quỹ đạo?
- Tại sao GRPO cần nhiều quỹ đạo cho cùng một dấu nhắc?
- Điều gì sẽ xảy ra nếu chức năng khen thưởng chỉ đo lường tính đúng đắn?
- Học trong runtime (s20-s21) giải quyết được cấp độ vấn đề nào so với đào tạo ngoại tuyến (s23)?
Một điều: Quỹ đạo cuộc trò chuyện là bản ghi kinh nghiệm của tổng đài viên. batch_runner thu thập chúng, axis_compressor nén chúng và GRPO học hỏi từ chúng -- làm cho khả năng của mô hình thế hệ tiếp theo trở nên mạnh mẽ hơn chứ không chỉ hiểu biết nhiều hơn.